

上一篇讲大语言模型时,提到它是一台“下一个词预测机”,但没展开说机器是怎么读懂句子的。这件事的答案藏在一个机制里,叫自注意力。2017 年 Google 的论文标题起得很狂,叫《Attention Is All You Need》,注意力就是全部所需。十年过去,这个标题基本应验了。
自注意力不是新词叠新词。它是一个具体的计算步骤,步骤清晰到可以用图书馆借书来打比方。看懂它,你对“大模型到底在算什么”的理解会从比喻落到实处。
一个句子,先难住机器
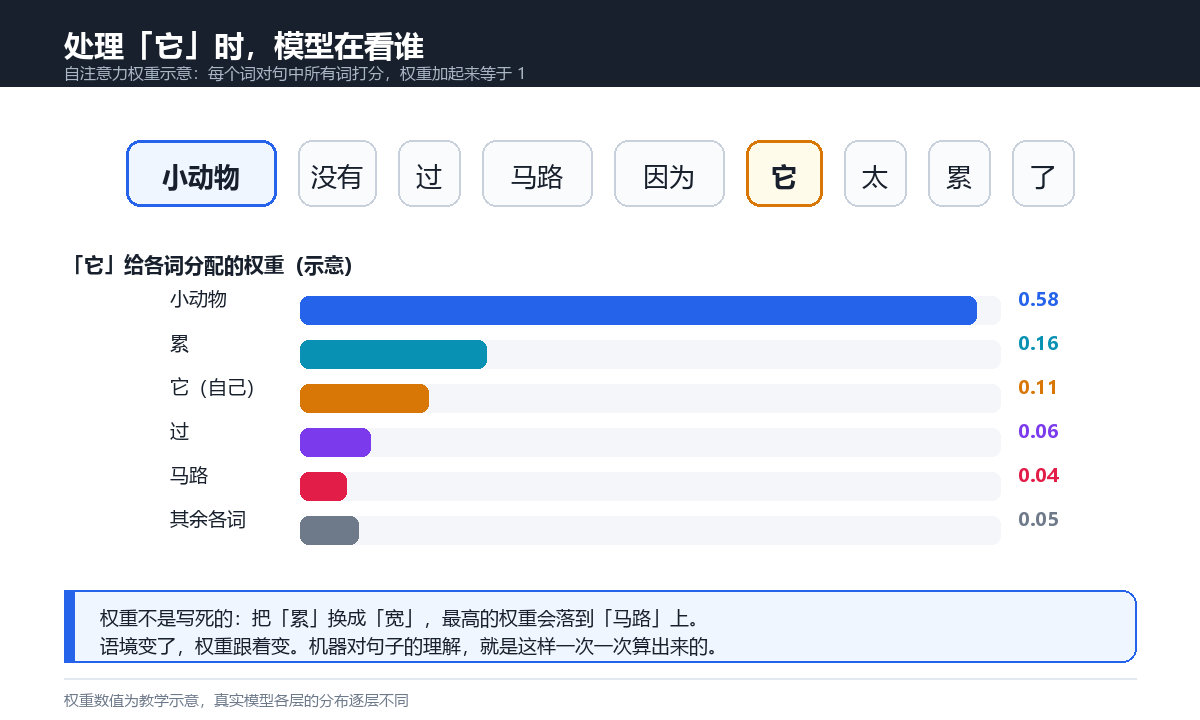
看这句话:小动物没有过马路,因为它太累了。
“它”指的是谁?你几乎是瞬间答出“小动物”,因为“太累”只说得通动物,说不通马路。换成“它太宽了”,答案就变成马路。人靠语境消歧义,毫不费力。
机器面对的正是这个问题。在自注意力出现之前,循环神经网络一个字一个字从左往右读,读到句尾时,开头的信息已经被一路稀释。两个词隔得越远,关系越难建立。自注意力的思路完全不同:让句子里每个词直接看一遍其他所有词,自己判断谁跟谁有关。不用隔着几十步传话,任何两个词都是直连。
机器具体怎么做:查询、键、值
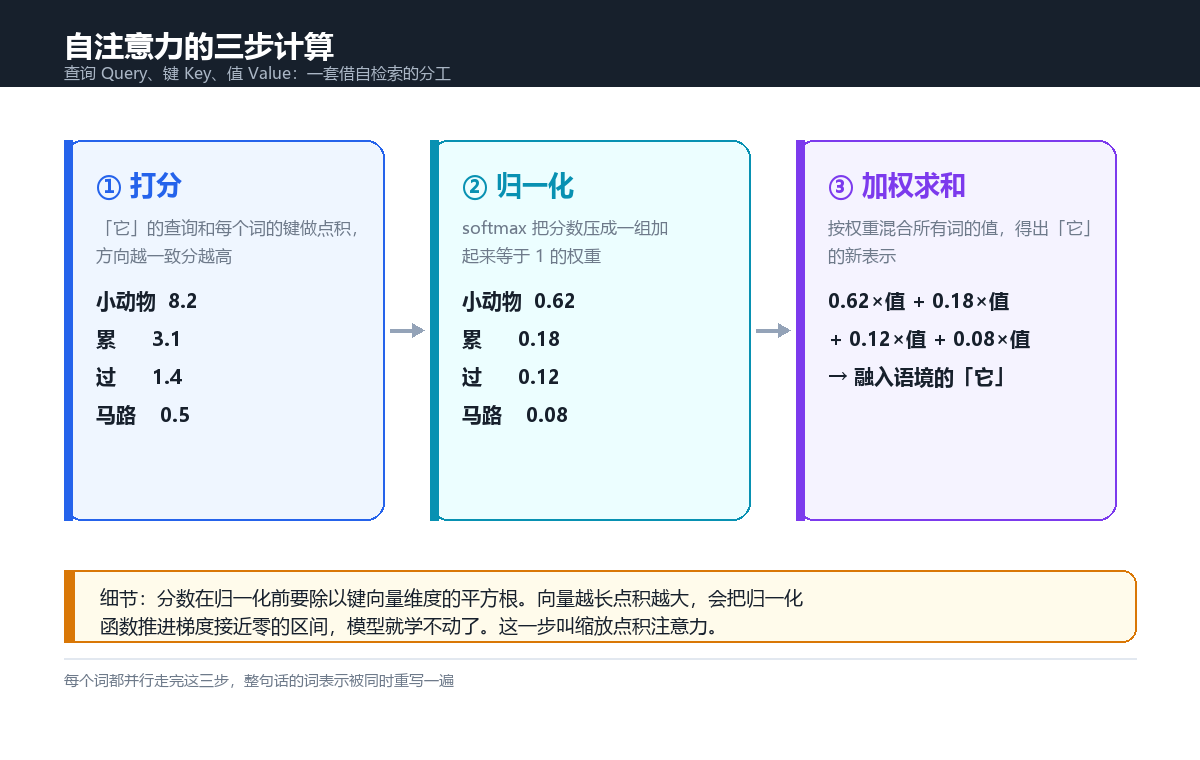
每个词会变成三个向量,名字借自搜索引擎:查询(Query)、键(Key)、值(Value)。
打个比方。你在图书馆找书,脑子里带着一个需求,这是查询;每本书脊上贴的标签是键,用来跟你的需求匹配;书里的内容是值,匹配上了才真正读进去。
回到句子。处理“它”这个词时,模型拿“它”的查询去和句中每个词的键比对,算出相关度分数,再把这些分数归一化成一组加起来等于 1 的权重。“小动物”匹配度高,权重就大;“马路”匹配度低,权重就小。最后,用这组权重给所有词的值加权求和,得出“它”的新表示。到这一步,“它”这个词携带的信息里,已经包含了“它是那只小动物”这个判断。
打分的办法说穿了不神秘:两个向量做点积,方向越一致,分数越高,和判断两张脸像不像是一个道理。有一个容易被略过的细节是,分数在归一化之前要先除以键向量维度的平方根。向量越长,点积的数值越容易大,会把归一化函数推进梯度接近零的区间,模型就学不动了。除一下,把分数拉回正常范围。论文里管这个叫缩放点积注意力,是全文最不起眼也最不能省的一步。
句子里每个词都并行做一遍同样的事,于是每个词都被整句的语境重写了一遍。这个过程就是“自”注意力的含义:自己这一句话内部,互相打分。
它为什么能取代循环网络
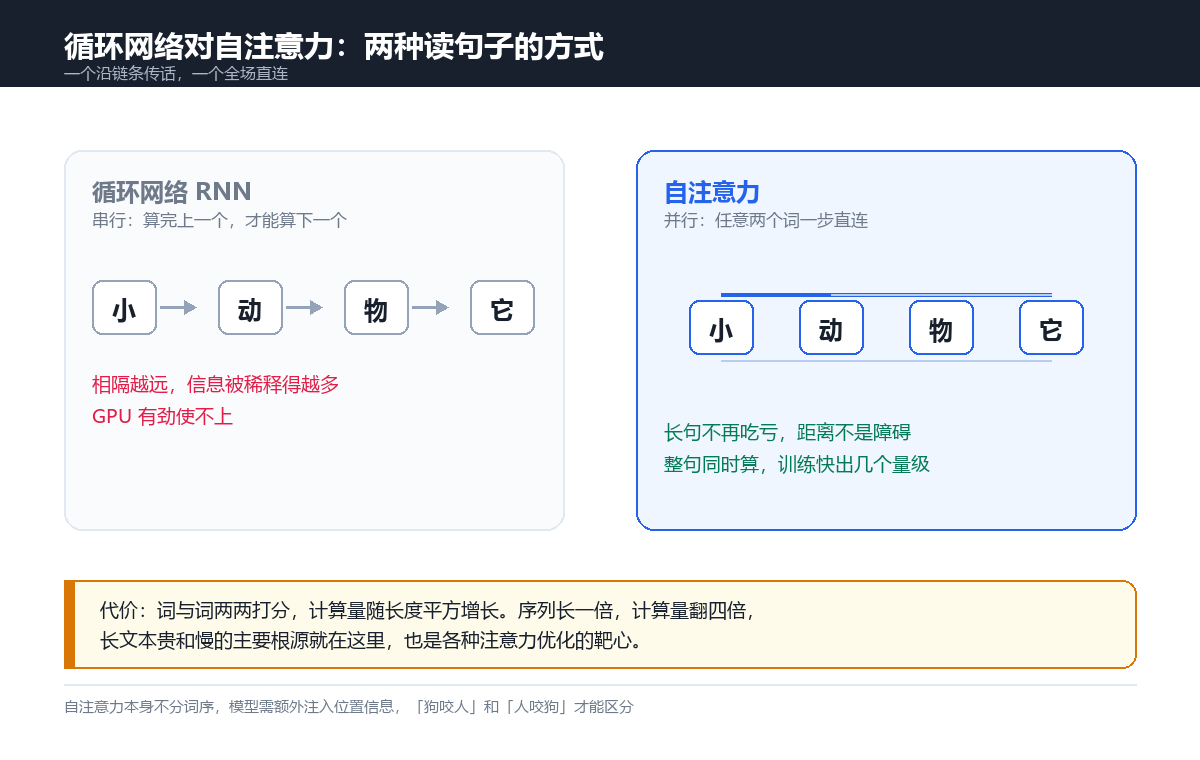
优势有两个,代价有一个。
第一是距离。循环网络里相隔一百步的两个词,信息要传递一百次;自注意力里任意两个词一步直达,长句不再吃亏。
第二是并行。循环网络必须算完第 99 步才能算第 100 步,GPU 有劲使不上。自注意力的全部计算就是几次矩阵乘法,整个句子同时算,训练速度快出几个量级。大模型能长到今天的规模,根基就在这里。
2017 年那篇论文提出整套架构之后,技术路线迅速收敛。BERT 管理解,GPT 管生成,今天主流语言模型几乎全是这个架构的变体。自注意力从论文里的一个公式,变成了整个领域的通用零件。
代价是计算量随长度平方增长。词与词两两打分,序列长一倍,计算量翻四倍。上下文窗口开到十几万词元的模型,光注意力矩阵就是百亿级别的条目。这是长文本昂贵的主要原因,也是近年各种注意力优化研究的靶心。
还有个细节:这套机制本身不分先后,“狗咬人”和“人咬狗”算出的注意力一模一样。所以模型要额外给每个词注入位置信息,词序才能被感知。
多头注意力:一次看清几种关系
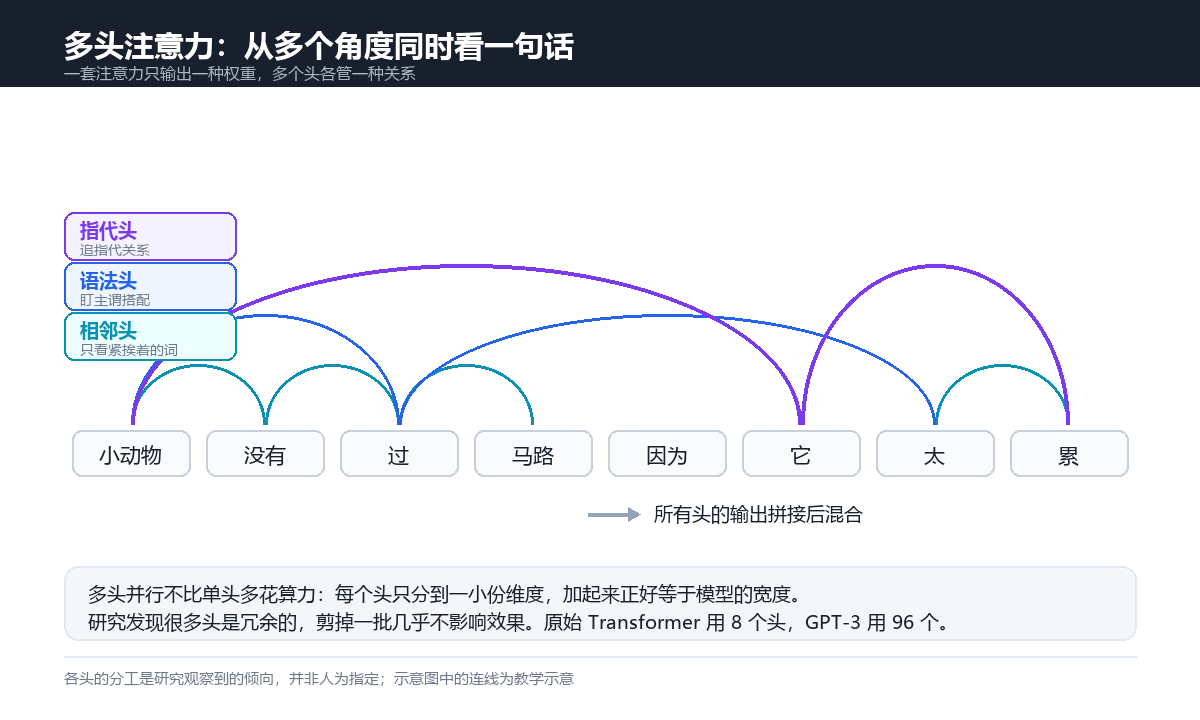
一个词需要同时理解多种关系:主语是谁、指代什么、旁边修饰词是什么。一套注意力只输出一种权重,等于只从一个角度看句子。
解决办法是把表示拆成若干份,每份独立跑一遍注意力,各叫一个“头”。原始 Transformer 用了 8 个头,每头 64 维,加起来正好等于模型的 512 维;GPT-3 用到 96 个头。因为每头只分到一小份维度,多头并行并不比单头多花算力。有的头盯语法搭配,有的头追踪指代,有的头只看相邻词。最后把所有头的输出拼起来混合。
后续研究还发现一件有意思的事:很多头其实是冗余的,剪掉一批几乎不影响效果。说明模型自己也没把编制用满。
权重看得见,但别急着当答案
自注意力的权重是一张可以画出来的表,哪个词看了哪个词、各占多少,一目了然。早期机器翻译靠这个画对齐图,翻译“the cat sat”时生成法语“chat”的注意力正好落在“cat”上,效果直观得让很多人相信这就是模型的思路。
后来的研究泼了冷水:注意力权重高,不代表那就是模型给出答案的理由。权重只是计算过程的一个中间量,模型真实的判断依据分布在整个网络里。所以看到网上流传的注意力热力图,当成观察窗口就好,当成解释依据就过了。
常见问题
自注意力和注意力机制是一回事吗?
不是。注意力 2014 年先出现在机器翻译里,解决的是翻译时“看原文哪里”的问题,是让输出那句话去看另一句话;自注意力是让一句话内部的词互相看。前者是循环网络上的补充件,后者是整个 Transformer 的地基,两者差着一个量级。
它和我说 prompt 时有什么关系?
理解机制对使用者有实际好处。模型靠上下文里的相关度决定读什么,所以关键信息放在提示词里,距离问题越近、表述越清楚,被“注意”到的权重通常越稳。长对话里前面交代过的要求被“忘掉”,多数时候不是记忆丢了,而是那一段在当前这一步拿到的权重太低。
上下文越长,注意力越累吗?
是。平方增长的算力开销落回到用户身上,就是长回答更慢、更长文本服务更贵。近年 FlashAttention 这类优化把内存开销大幅压低,长上下文才变得可用,但平方增长的趋势本身没有变,只是把墙推远了。
写在最后
自注意力一句话概括:让每个词看遍全句,按相关度加权吸收别人的信息,把自己重写一遍。距离不再是障碍,计算可以并行,代价是平方级开销。理解了它,再回头看大语言模型为什么是“下一个词预测机”,很多细节就串起来了。
下一篇讲 Transformer 的整体结构,把这个机制放回它的位置。
相关文章








