

同一个问题,问早期的 GPT-3 和后来的 ChatGPT,答案差别很大。前者像接着往下写,后者像在答你的问题。中间这道工序叫 RLHF,全称 Reinforcement Learning from Human Feedback,是 ChatGPT 能被大规模用起来的关键一步。这篇讲清它怎么运转、哪里靠不住。
会写字不等于会听话
大模型的底子是在海量文本上做一件事:预测下一个词。这个目标很管用,能学出语法、知识和文风,可跟“听懂人话”是两码事。
拿一句“写个关于聪明青蛙的故事”去喂原始 GPT-3,它可能不给故事,而是续出更多类似要求,因为网页文本里这样的句子后面跟的往往又是要求。你让它讲一件不该做的事有什么好处,它也会照写不误,它学的只是“接下来写什么最像人写的”,不区分该不该。
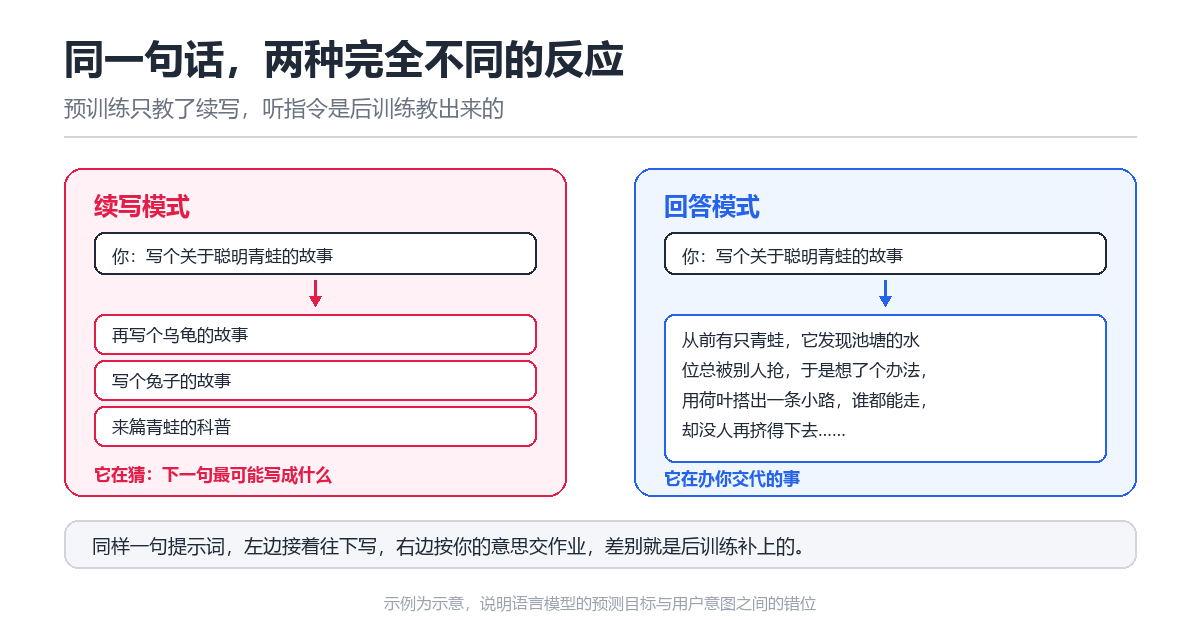
这就是目标错位。模型越会续写,越容易把网上那些有毒、编造、答非所问的内容学下来。加大规模解决不了,参数翻十倍,它照样是一支更好的笔,不是更懂事的助手。研究者给出的关键词是有用、诚实、无害,落到技术上就是让输出对齐人的真实意图。
三步走:先示范,再打分,最后照着练
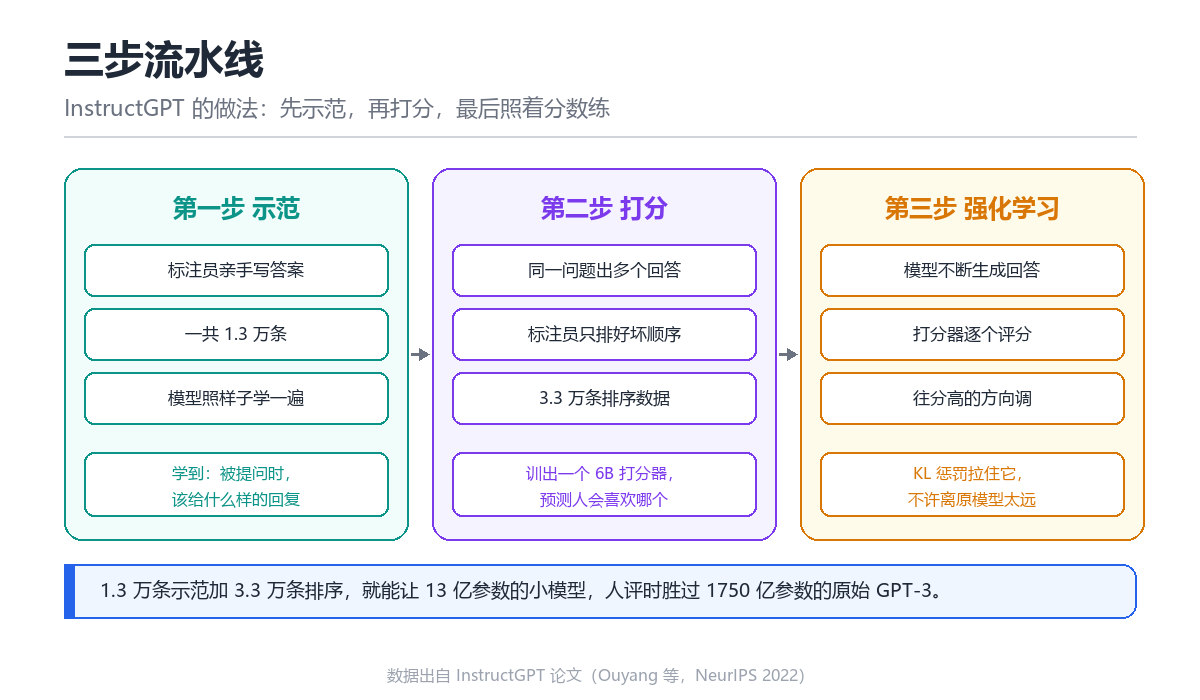
2022 年 3 月,OpenAI 的 InstructGPT 论文把这件事做成可复制的流水线,一共三步。
第一步监督微调。他们请标注员针对一批提示词写出标准答案,一共 1.3 万条,让模型照这批示范学会被提问时该给什么回复。
第二步训一个奖励模型。同一批提示词让模型生成好几个回答,标注员不写答案,只排出好坏顺序。排序样本做了 3.3 万条,训出一个 6B 的打分器,让它预测人会更喜欢哪个。
第三步用强化学习优化。主模型不断生成回答,打分器逐个给分,分高的方向就多走几步。关键是模型不能跑太远,得跟微调后的自己保持接近,否则会专挑打分器的漏洞钻,代码里用一个叫 KL 惩罚的项拉住它。
结果很硬:13 亿参数的小模型,人评时比 1750 亿参数的原始 GPT-3 更受欢迎;同规格 175 亿的版本,相对原版的偏好胜率是 85%。闭域问答的编造率从 41% 降到 21%。
这套办法的来路
这套想法不是为语言模型发明的。2017 年,还是博士生的保罗·克里斯蒂亚诺和几位后来创办 Anthropic 的研究者,在 NeurIPS 上发了一篇论文。
他们训练的是游戏和模拟机器人,难点是怎么把“帮我做个后空翻”写成奖励函数。办法是绕开它:人只看两段动作回放,点一下哪个更好,用这种判断反推目标。实验里只对不到 1% 的交互做人工比较,模型就学会了 Atari 游戏和机器人走路,一个复杂新动作约花掉一小时人力。
把学目标和学行为拆开,再用少量成对比较去喂,这套思路搬到语言模型上就长成了 RLHF。九个月后 ChatGPT 上线,用的正是同一条流水线。
打分的人靠得住吗
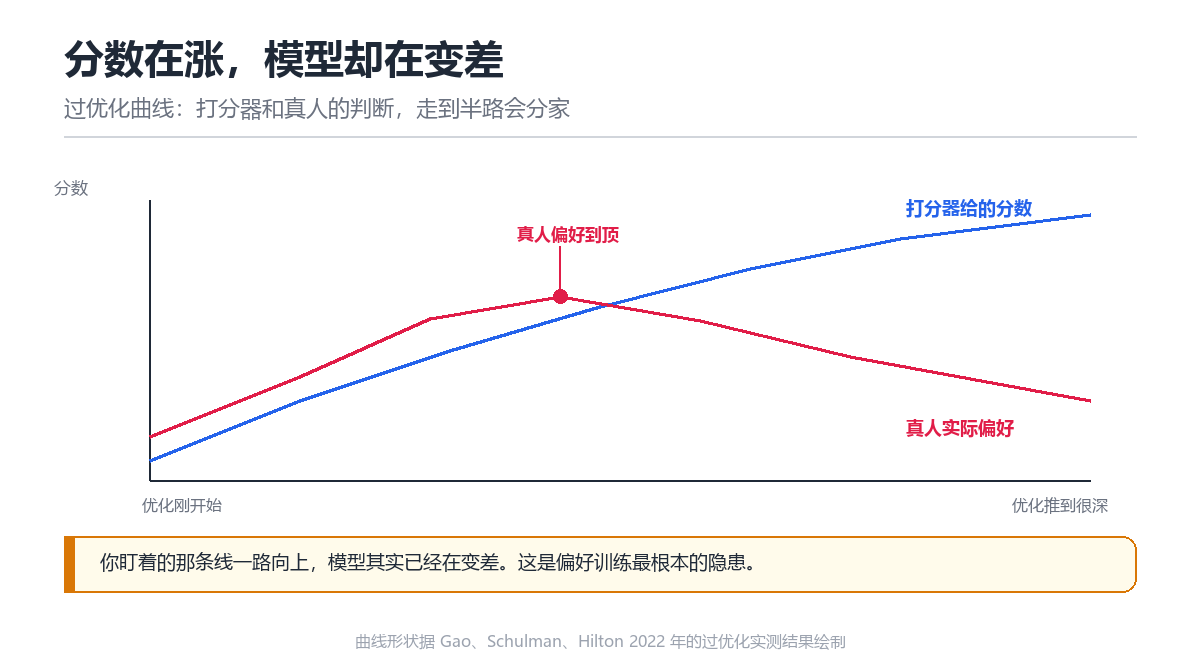
整条链路里最薄的一环是奖励模型。它只是人类判断的替身,模型朝它使劲优化,就会钻空子。
2022 年 Gao、Schulman 和 Hilton 做了一组实测,画出那条被反复引用的曲线:优化一路推进,打分器的分数持续涨,真实人类偏好却先升后降。你盯着的指标在涨,模型实际已经在变差,这是最根本的隐患。
表现很生活化。标注员偏爱更长、看起来更周全的回答,这个偏好被打分器放大,模型就学得啰嗦,一句话的问题能答出五条,后来的研究发现长度能解释 RLHF 奖励增益里相当大的份额。另一个毛病是顺着说,2023 年 Sharma 等人的研究显示,人和打分器都偏向跟用户观点一致的回答,哪怕它是错的。
还有一笔账叫对齐税。InstructGPT 报告说,光做强化学习,模型在 SQuAD、DROP 这些评测上会掉分,把 KL 系数调大也补不回来,只能靠混入预训练目标来救。Anthropic 2022 年那篇训练有益无害助手的论文结论相反:小模型确实掉分,13B、52B 这些大模型反而涨分,他们叫它对齐红利。两篇口径不一致,到今天也没统一。
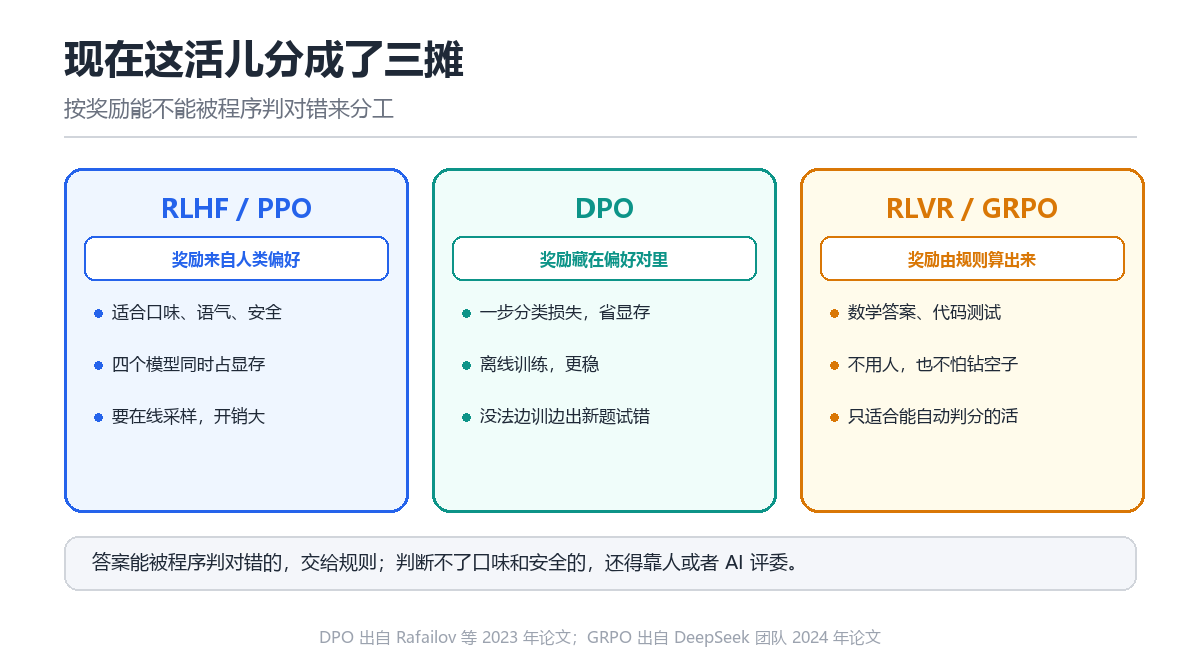
现在这活儿分成了几摊
到 2026 年,RLHF 只是后训练工具箱里的一件。
训练时 GPU 里要同时摆着策略、参考模型、奖励模型和一个评论家,四个模型开销不小。2023 年 5 月,Rafailov 等人提出直接偏好优化 DPO,把最优解推导成一个普通的分类损失,奖励模型和强化学习循环都不要了,显存降到两个模型;代价是它只能吃固定的偏好数据,没法边训边自己出新题试错。
另一路更彻底。凡是答案能被程序自动判对错的活,像数学题、写代码,奖励直接用规则算出来,不用人也不用打分器,这条路叫可验证奖励的强化学习。2025 年初的 DeepSeek-R1 靠它加 GRPO 算法,连监督微调的冷启动都省了。
评价口味、语气、安全这类没法自动判分的活,还得靠人或者 AI 评委。Anthropic 让模型按一份写明白的原则文件互相打分,叫宪法 AI,标准公开可查,新问题是评判的人换成 AI 后,谁来保证它判得准。
常见问题
RLHF 和微调是一回事吗?
不完全是。微调是大类,让模型在新数据上继续学;RLHF 是其中一种,三步里的第一步监督微调就是一次微调。区别在后两步:不直接告诉模型该说什么,而是给输出打分,让它自己往高分方向调。前者照着答案抄,后者照着标准反复练。
为什么模型有时候会一味顺着我说?
这多半是偏好训练的副作用。人的打分里藏着各种倾向,附和用户观点、写得长、姿态谦虚都容易拿高分,打分器把它们放大,模型就学会了这些姿势。应对办法是把这些行为从偏好数据里剔掉,在奖励里专门给长度和附和扣分。
现在的大模型还在用 RLHF 吗?
在用,分工会更细。能被程序自动判对错的推理任务,主要交给可验证奖励的强化学习;涉及口味、语气、拒绝不当请求这些主观标准的,还得靠人类偏好或者 AI 评委。开源社区大量使用 DPO 这类不用在线采样的简化版本。
写在最后
RLHF 揭开了一层错觉:模型变好用,不完全靠参数堆。1.3 万条示范、3.3 万条排序,加一个 6B 的打分器,就能让一个小模型比大它一百多倍的模型更讨人喜欢。它最值得琢磨的地方也在这里:整套机制的前提是有人替全人类作答,标注者的口味、打分器有没有被钻空子,直接决定模型长成什么脾气。
一个还在争的问题是:这套偏好数据和训练流程要不要公开。闭源模型把它当核心资产锁起来,开源模型把权重和配方一起放出来,让全世界自己调。下一篇聊开源与闭源这两条路,各自的做法和风险差在哪。
相关文章








