

你在搜索框里打一句人话,输入法替你猜出下一个词,翻译软件把一段英文变成通顺的中文,客服机器人接住你的抱怨并给出退款入口。这些事情的背后是同一套技术,自然语言处理,英文缩写 NLP,指的是让计算机理解和生成人类语言的一整套方法。
自然语言处理到底是什么
语言依赖语境、省略和默契。机器拿到的只是一串符号,它不会自动明白“今天有点冷”是在陈述天气,还是在暗示你想关窗。
自然语言处理要做的,就是把这串符号换成机器能计算的数字和关系,算完再换回人话。它融合了语言学、计算机科学和机器学习,目标只有一个,让人和机器用日常语言沟通,不必去学代码或者点按钮。
方向有两个。自然语言理解负责读懂,自然语言生成负责写出。今天的大模型把这两件事装进同一个模型,理解和生成几乎是同一套机制的正反面。
有一组概念常被混在一起。语音识别管声音怎么变成文字,语音合成管文字怎么变成声音,走的是听觉通道;自然语言处理管文字到手之后怎么理解、怎么生成。两者是前后接力,不是一回事。
它具体要解决哪些任务
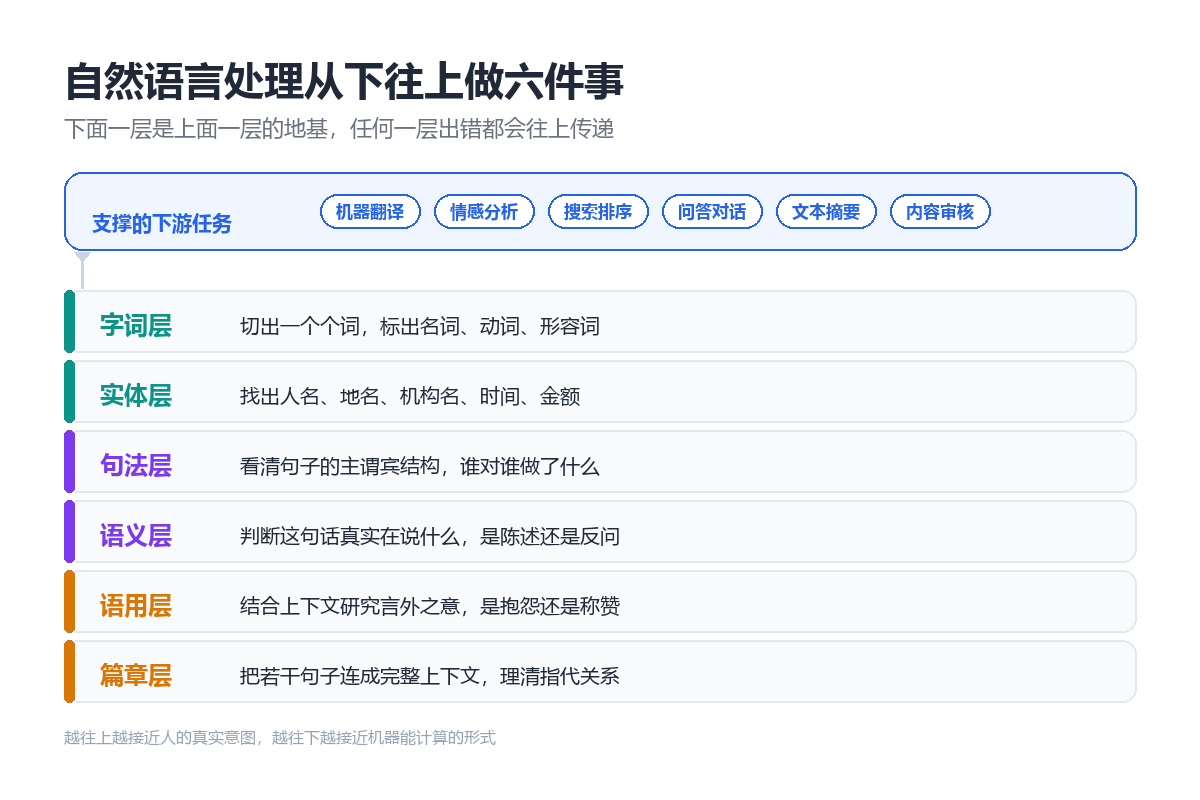
把自然语言处理拆开看,它是一条自下而上的流水线。
最底层是分词,机器得先知道一句话里有哪些词。接着是词性标注,标出哪个是名词、哪个是动词。再往上是命名实体识别,把人名、地名、机构名、时间、金额抠出来。之后是句法分析,看清主谓宾结构。最后是语义理解,判断这句话真实在说什么。
这些底层工作支撑着搜索、机器翻译、情感分析、问答系统这些熟悉的场景,也让上一环的错误直接变成下一环的错误。分词把“光大银行”切成“光大”和“银行”,后面的风险判断可能整段失效。
这件事难在哪里
难在语言本身就含糊,人靠语境补齐,机器没有这种直觉。
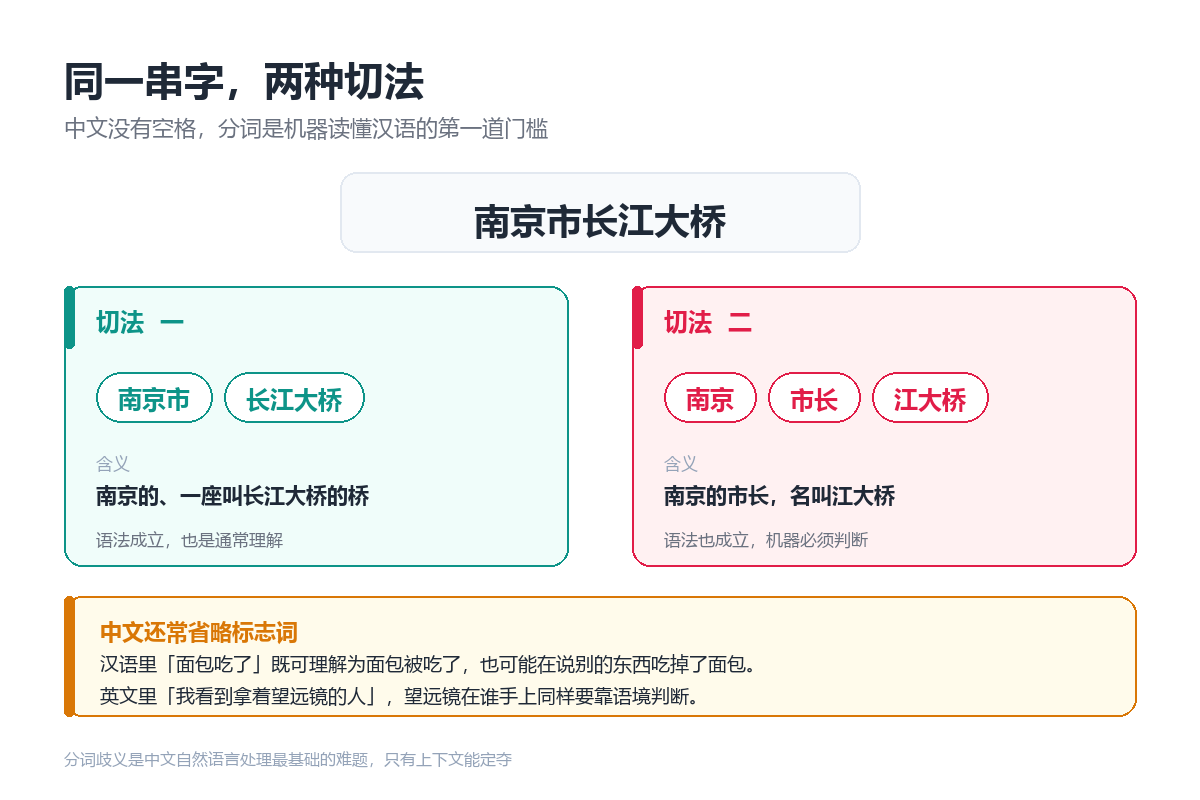
中文还有一层额外难度。英文单词之间有空格,机器照着切就行;中文是一长串连着写的字,切法不同意思就不同。“南京市长江大桥”可以切成“南京市/长江大桥”,也可以切成“南京/市长/江大桥”,两种切法语法上都成立,只有上下文能定夺。
省略同样麻烦。汉语里说“面包吃了”,意思其实是面包被吃了,可句子里根本没有“被”字;说“约翰吃了”,实际可能是“约翰把面包吃了”。早期照搬英文语法体系的研究,在这里反复受挫。
歧义不只属于中文。英文里一句“我看到拿着望远镜的人”,望远镜在人手里还是在我手里,同样要靠语境判断。人读到这句话几乎不犹豫,机器必须明确消解一次。
这些难点都没有被彻底解决,只是被绕开了。
从规则到神经网络,走了七十年
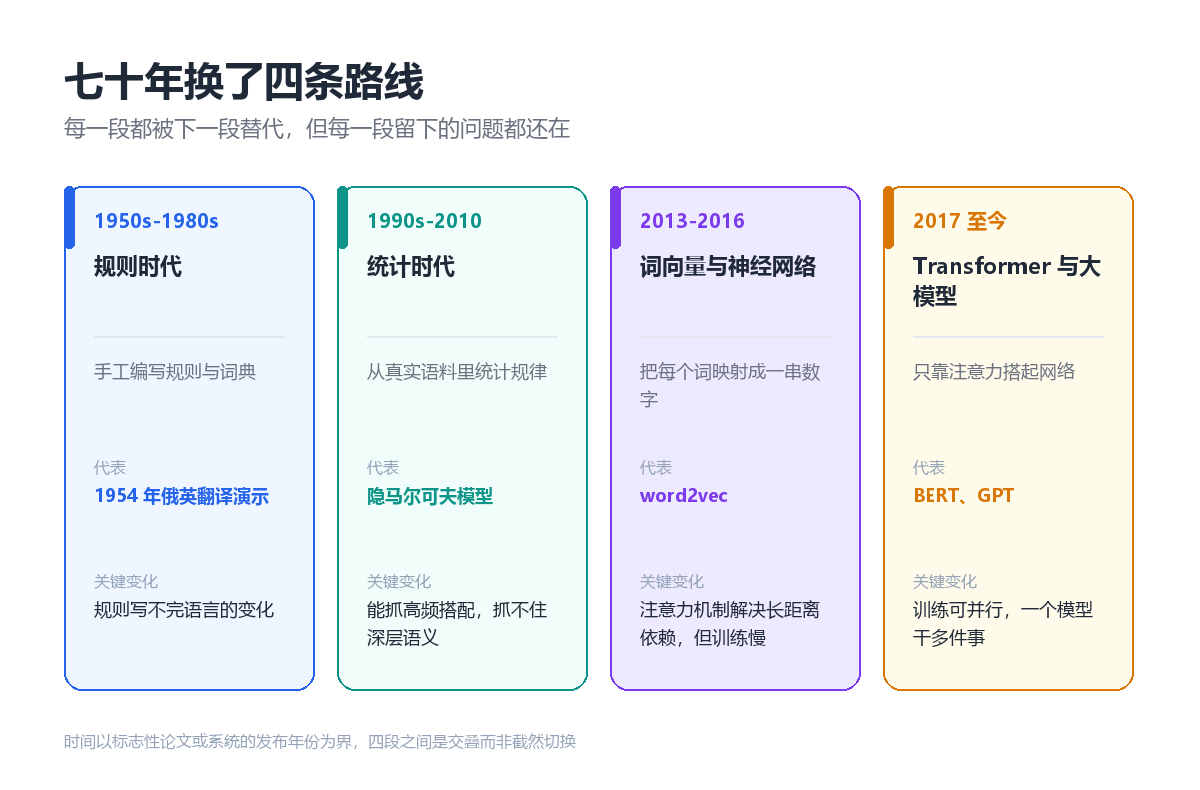
自然语言处理的路线大致换过四回。
1950 到 1980 年代是规则时代,靠手工编写语法规则和词典。1954 年乔治城大学与 IBM 联合做过俄英机器翻译演示,当时认为几年内就能解决,1966 年的 ALPAC 报告给出了相反结论。
1980 年代后期到 2010 年前后是统计时代,改从真实语料里统计规律,隐马尔可夫模型和 n 元语言模型成了主角,句法分析第一次有了统一的评测基础。它的天花板也清楚,能抓住高频搭配,抓不住深层语义。
2013 年前后进入词向量与神经网络时代,word2vec 把每个词映射成一串数字,词义相近的词在数字空间里挨得很近。
2017 年至今是 Transformer 与大模型时代。谷歌那篇《Attention Is All You Need》提出只靠注意力搭网络,取消循环结构,训练可以大规模并行,BERT 和 GPT 由此确立了两种预训练路线。
预训练改变了什么
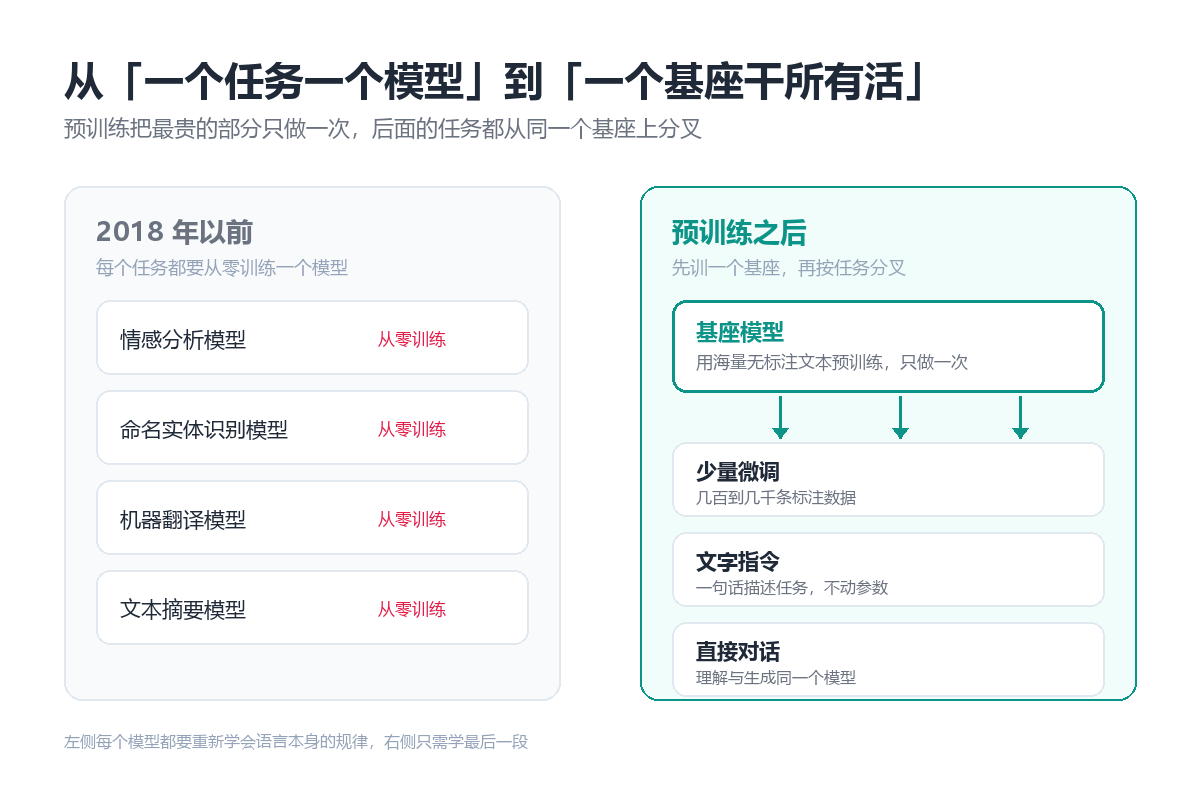
真正被改变的是工作方式。2018 年以前,做自然语言处理是“一个任务配一个模型”。做情感分析训练一个,做命名实体识别再训练一个,做翻译还得另起一个,每个模型都要重新学会词是有意义的、上下文很重要。
预训练把这套逻辑翻了过来。先用海量无标注文本训练一个基座模型,再针对具体任务做少量微调,或者只用一段文字指令去引导。2021 年有一项实验很能说明问题,一个 1370 亿参数的模型在六十多个任务上做过指令微调后,在 25 项评测里赢了参数更大的 GPT-3。
中文在这里也受益。预训练要先把文本切成词元,词表怎么定直接影响成本和效果。中文比例高的词表切得更整,一个词元平均能装下一点三个汉字;以英文为主的旧词表对中文不友好,一个词元连一个汉字都装不满。
你今天在哪里用到它
搜索是它最早的战场。你输入“附近能带狗的咖啡馆”,它要把这句话拆成地点、条件、对象,再去找匹配的结果。
输入法在替你算下一个词,翻译软件在对齐语序,内容平台用它做审核和推荐,企业用它做客服和舆情监测,金融与医疗行业用它从合同、病历里抽关键字段。手机上的语音助手,则是语音识别加自然语言处理的组合。
大模型是这门技术目前最显眼的形态,但它不等于全部。检索、抽取、分类这些传统任务仍然在大量系统里跑着,它们更小、更快,也更可控。
常见问题
自然语言处理和计算语言学是一回事吗?
不尽相同。计算语言学偏语言学一侧,关心用计算手段验证和改进语言理论;自然语言处理偏工程一侧,关心把系统做出来、跑得准。两者研究的问题大量重叠,日常语境里常被当作同义词使用。
学自然语言处理一定要数学很好、会写代码吗?
看你想走到哪一步。当使用者,会提问、会核实、知道模型在哪容易出错,比懂数学重要得多。想自己训练或者微调模型,线性代数、概率统计和编程就绕不过去。也有不少岗位要的不是从零建模,而是把现成模型接到业务里,难点在数据质量和评测标准。
大模型出来以后,还有必要单独学自然语言处理吗?
有必要,只是重点变了。模型把分词、句法分析包进了内部,你不再需要手工实现,但必须知道它们存在,才能理解模型为什么会在某些输入上失手。中文没有空格、歧义句要靠语境,这些问题在大模型时代依然成立。
写在最后
这门技术的全部努力,总结起来是一件事,让机器在没有直觉的情况下,尽量靠近人在听话和说话时的判断。
对普通使用者来说,记住三点就够用了。歧义不靠语法解决,靠语境,机器在这件事上永远慢一步;词被切成什么样,会直接影响模型的表现和你的花费;系统错得最有规律的地方,往往正是分词和歧义这些最基础的环节。
下一次遇到模型答非所问,不妨先想想,是它没听懂,还是你这句话本来就留了两种理解。
相关文章








