

上一篇拆解了自注意力机制,结尾留了个尾巴:这个机制嵌在哪个身体里?答案是 Transformer。2017 年之前,注意力只是循环网络外挂的一个小部件;那一年之后,它成了整个架构。今天所有叫得上名字的大模型,GPT、BERT、Claude、Gemini、DeepSeek,用的都是这一副身体。一篇做机器翻译的论文,为什么配得上里程碑三个字?这篇把这座建筑完整拆开给你看。
自注意力当主角之前,序列模型是怎么干活的
注意力 2014 年被发明出来时,只是给循环网络打的补丁。循环网络必须像传话一样逐词接力,第 99 步的信息传到第 100 步已经很淡,序列一长,最早的信息几乎丢光;注意力让输出端可以回看输入,但传话本身仍是串行的,GPU 的算力使不上劲。这套补丁方案统治了机器翻译好几年,天花板也越来越明显。
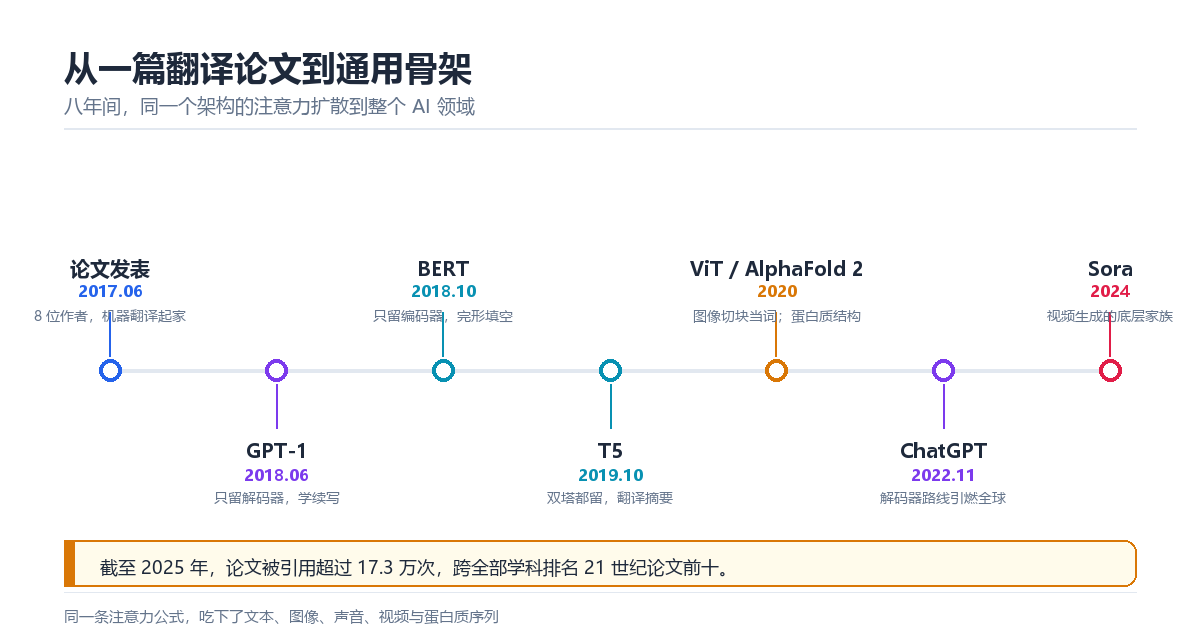
2017 年 6 月 12 日,8 位来自 Google Brain、Google Research 和多伦多大学的研究者把论文挂上 arXiv,标题毫不客气:Attention Is All You Need,注意力就是全部所需。他们把循环和卷积整个扔掉,让注意力从补丁升为主角。当时没人想到,这篇做机器翻译的论文,会成为此后十年 AI 的地基。
一座双塔:理解者和创作者
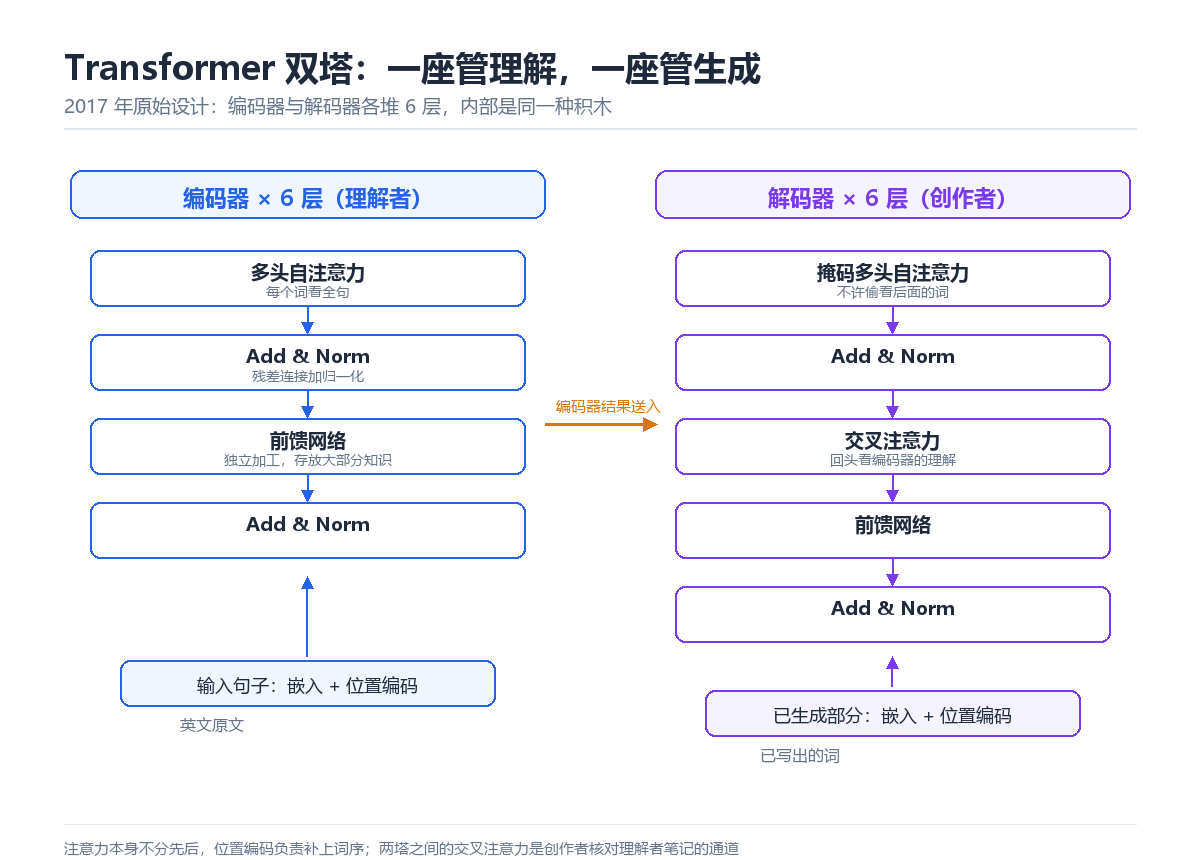
Transformer 是编码器加解码器的双塔结构。编码器负责理解,把输入句子压成一层带语境的表示;解码器负责生成,参考编码器的理解和已写出的部分,逐词吐出目标句子。
两座塔用同一种积木搭成。原始论文各堆 6 层,每层两件套:多头自注意力让每个词看全句,前馈网络对每个位置独立加工,模型的大部分知识就存放在这里。每个子层外都包着残差连接和层归一化,前者让梯度能一路流回底层,深网络才训得动,后者稳住每层伽马值的尺度。
三处细节各有讲究。位置编码:注意力本身不分先后,用三角函数给每个词标位置,词序才能被感知。解码器里的掩码:生成第几个词时不许偷看后面的答案,训练才不会作弊。两塔之间还有一层交叉注意力,让创作者随时回头核对理解者的笔记。
顺带说清名字。Transformer 直译是“变换器”,它干的本职就是变换:把一段文字变成带语境的表示,把英语变成法语。
成绩之外,赢的是可扩展性
论文在 WMT 2014 英德翻译上拿到 28.4 BLEU,比此前最好成绩高出 2 个点以上,对手还包括多个模型集成的方案;英法翻译 41.8,创下当时单模型纪录。训练用了多久?8 块 P100 GPU,3.5 天。同一时期顶级翻译模型的训练成本,通常以数周和更多卡来计。
真正的价值在结构上。循环网络堆不深、快不起来,梯度传几层就衰减殆尽;Transformer 的层可以无限往上摞,算力给多少吃多少。两年后研究者发现摞得越大能力越强,缩放定律登场,大模型时代由此开启。回头看,2017 年那场比赛赢的只是翻译,架构真正赢下的,是往后所有模型长大的可能性。架构撑得起规模,这才是里程碑三个字的分量。
2018 年,这座塔被拆成三条路
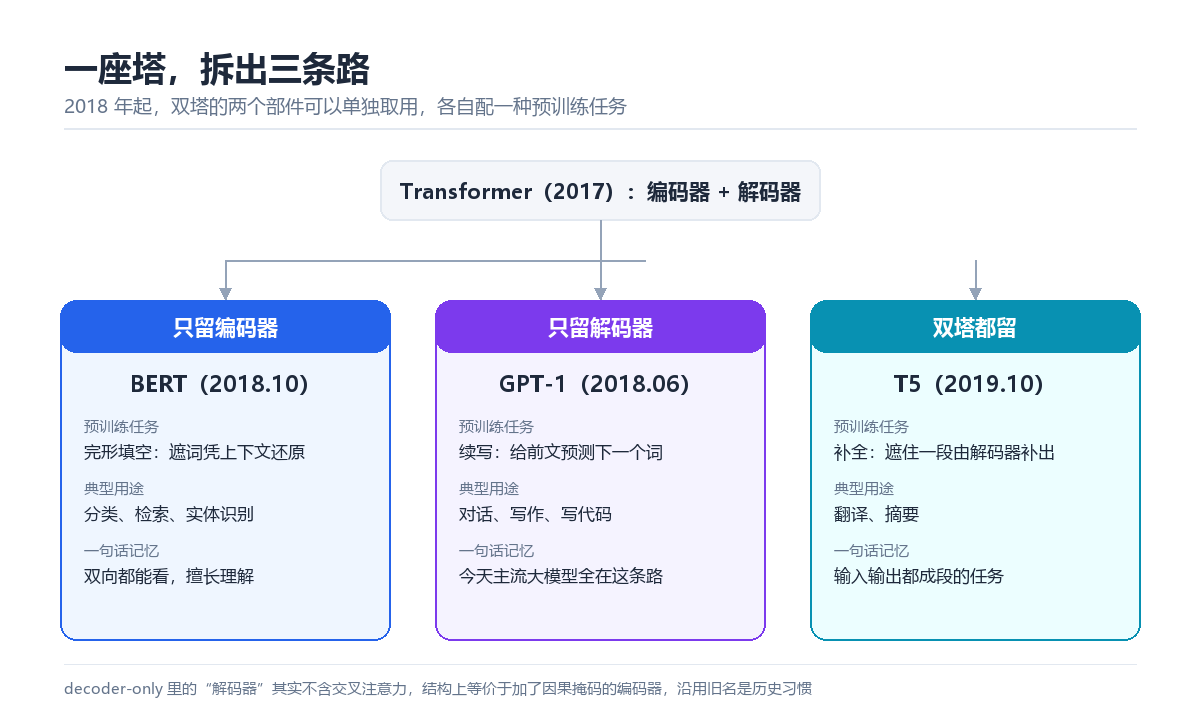
双塔很快被发现可以拆开单独用,三条分支就此成形。
只留编码器,走 BERT 这条路。预训练任务是完形填空,随机遮住句子里一些词,让模型凭前后文还原。双向都能看,擅长理解,分类、检索、实体识别归它管。
只留解码器,走 GPT 这条路。预训练任务就是续写,给前文预测下一个词。GPT-1 在 2018 年 6 月出世,比 BERT 还早四个月。后来的一切你已经知道,今天的主流大模型几乎全是这条路线。
双塔都留,走 T5 这条路,翻译、摘要这类输入输出都成段的任务最适合它。
一个冷知识:decoder-only 模型里的“解码器”其实不含交叉注意力,因为没有编码器可看,结构上它等价于一个加了因果掩码的编码器,沿用旧名只是历史习惯。
为什么最后是续写这条路线赢到今天?任务简单统一,给前文预测下一个词,语料和算力加进去就能继续涨,工程上最容易堆规模。理解类的活,生成式模型在足够大之后也接了过去。
跨出语言之后,它成了 AI 的通用骨架
2017 年它做的是翻译。2020 年,ViT 把图像切成小块当词来读,视觉领域从此有了新的主力架构;Whisper 用同一套架构做语音识别,覆盖数十种语言;AlphaFold 2 借它预测蛋白质三维结构,解决了一个悬置五十年的生物学难题;视频生成模型 Sora 的底层也是 Transformer 家族。文本、图像、声音、视频、蛋白质序列,到这里全都能折算成序列。连多模态模型也是同一个思路:图像走一条编码通道,文字走另一条,最后汇合在同一种注意力里互相参照。
截至 2025 年,这篇论文被引用超过 17.3 万次,跨全部学科排名 21 世纪论文前十。一套为翻译设计的架构吃下整个 AI 领域,这种情况在科学史上并不多见。
八位作者,后来都去了哪里
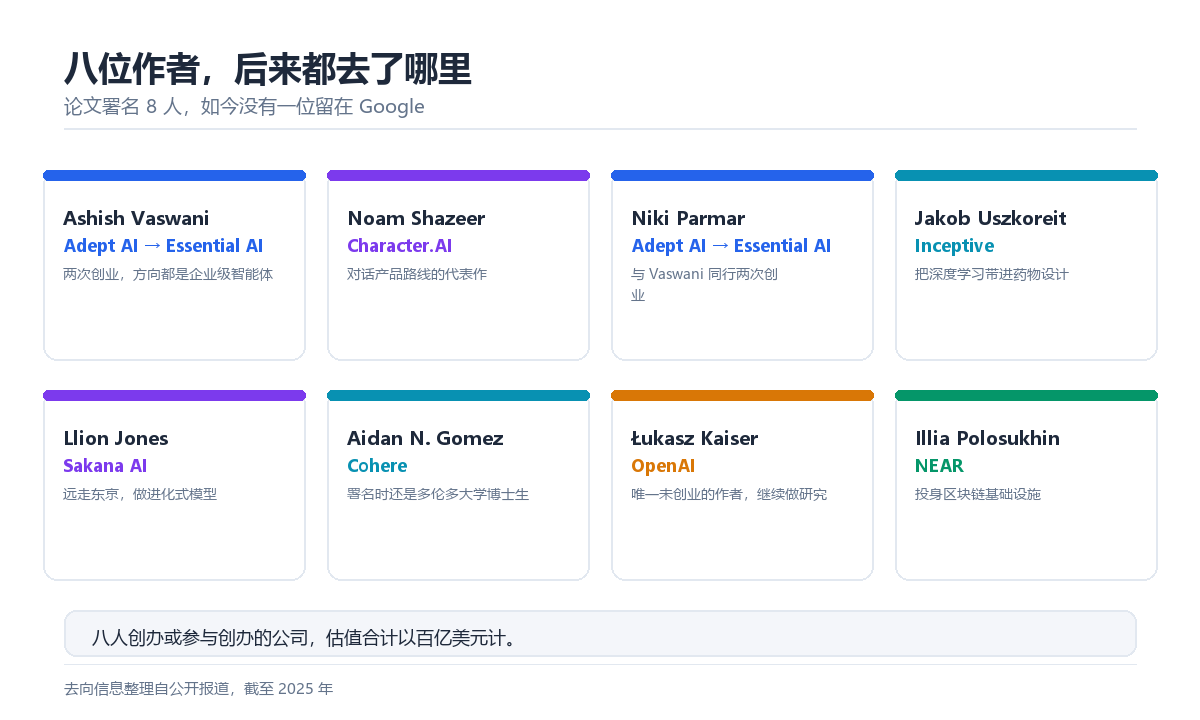
论文署名 8 人,如今没有一位留在 Google。Noam Shazeer 联合创办了 Character.AI,Aidan Gomez 联合创办了 Cohere,Llion Jones 远走东京联合创办 Sakana AI,Illia Polosukhin 参与创办了 NEAR,Vaswani 和 Parmar 先后创办 Adept AI 与 Essential AI。当年署名列表里,Gomez 还是多伦多大学的博士生,是唯一来自学术界的合作者。唯一没有创业的 Lukasz Kaiser 去了 OpenAI 做研究。八人创办或参与的公司,估值合计以百亿美元计。一篇论文养活一个行业,这句话用在这里不算夸张。
常见问题
Transformer 和大语言模型是一回事吗?
不是。Transformer 是建筑图纸,大语言模型是照图纸盖起来的楼。图纸也能盖别的楼,BERT、Whisper、ViT 都出自这个架构,但不算语言模型。反过来,今天主流大语言模型的底下,都是 Transformer。产品宣传里两个词经常混着用,知道这层区别,看新闻时不容易被绕进去。
它自己会被新架构取代吗?
有人正在尝试。Mamba 这类状态空间模型把计算量从平方降到线性,理论空间更大。但 2026 年的行业共识是混合架构:关键层保留注意力,其余换成更省的组件。纯状态空间模型在长文本精确检索上还打不过注意力。取代谈不上,改造一直在进行。
学 AI 需要搞懂它的数学吗?
看目标。当使用者,知道上下文窗口、知道模型靠相关度读文本,比会推导公式有用得多。想往架构和训练方向走,线性代数和概率论绕不过去,论文原文反而比多数二手资料更易读。
写在最后
Transformer 的故事可以压缩成三句话:把附件扶正,把串行改并行,把规模的可能性留给未来。你今天用到的每一次 AI 问答,底层都是这套 2017 年搭起来的骨架。
下一篇回到最小的零件:词元 Token。你输入的每个字是怎么被切成模型的口粮的,那是理解大模型计费方式和长文能力的起点。
相关文章








