

跟 AI 聊得久了,它会忘了你最开始交代过什么;贴一份长报告让它总结,它可能漏掉中间几页的关键结论;换个新对话,它又什么都不记得了。这些现象都指向同一个东西,上下文窗口。它是大模型的记性边界,理解了它,很多怪现象就解释得通。
窗口是什么,一张共享的草稿纸
上一篇讲词元时提过,模型读文字的单位是词元,不是字。上下文窗口衡量的就是词元:模型一次能处理的词元总量上限,超过这个数,多出来的内容它看不见。
常见的比方是把窗口想成一张大小固定的草稿纸。你写的问题、贴的文档、前面聊过的所有内容,加上模型正在写的回答,全都要挤在这一张纸上。纸写满了,要么报错,要么最早的聊天记录被挤出去。
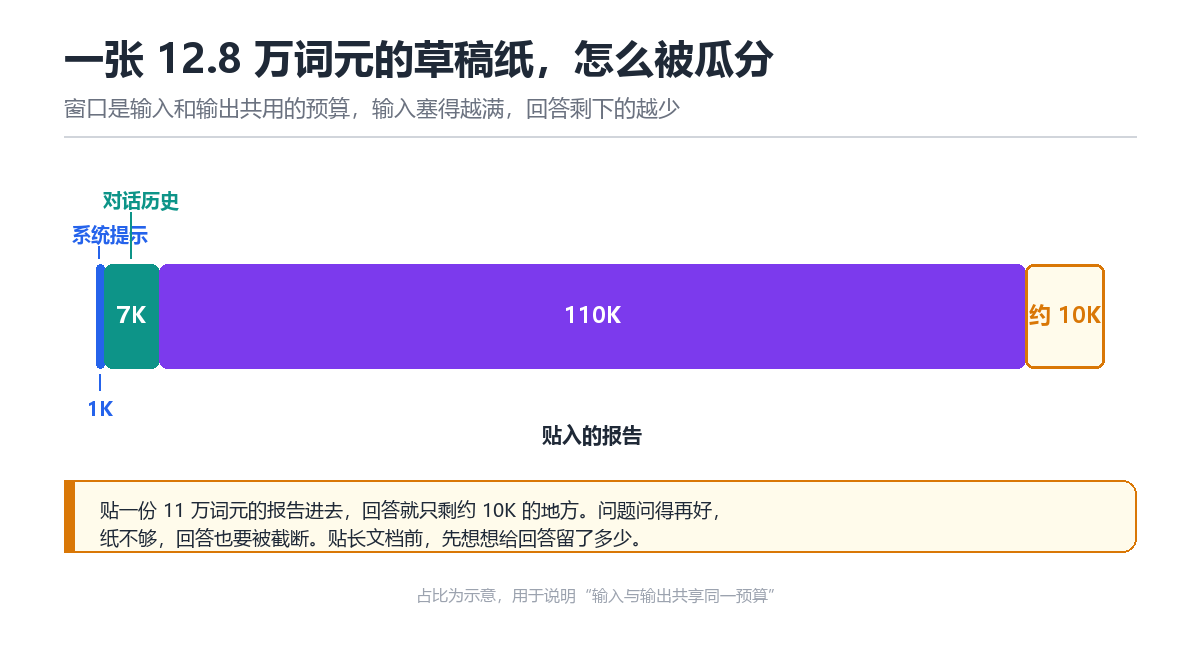
最容易忽略的一点:这张纸是输入和输出共用的。假设窗口 12.8 万词元,你贴进去的报告占了 11 万,留给模型写回答的就只剩不到 2 万。问题问得再好,纸不够,回答也得被截断。所以贴长文档之前,先想想给回答留了多少地方。
严格说还有一对术语要分清:上下文长度是模型架构允许的最大序列长度,是理论上限;上下文窗口是实际使用时的空间。多数场合两者混用,不用较真,但要记住一点,窗口是硬边界,不是软建议。
窗口是这么长大的
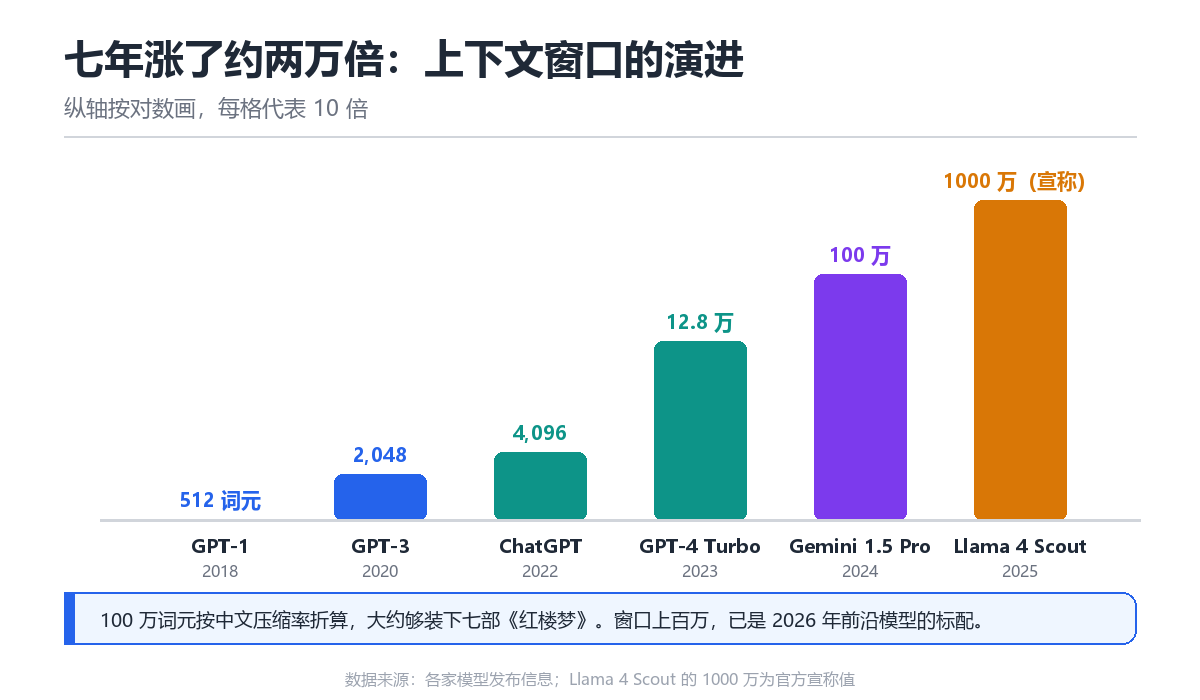
七八年间,这个数字涨了约两万倍。
2018 年 GPT-1 只有 512 词元,大约一页纸;GPT-2 翻倍到 1024,GPT-3 到 2048;2022 年底的 ChatGPT 还是 4096,聊几轮就满。真正的跳跃从 2023 年开始:GPT-4 先出了 8K 和 32K 两个版本,年底 GPT-4 Turbo 跳到 12.8 万,够装一本三百页的书;Claude 在 2023 年 5 月第一个摸到 10 万,同年 11 月的 Claude 2.1 做到 20 万;2024 年 Gemini 1.5 Pro 直接跳到 100 万词元,后来又开到 200 万;2025 年 Llama 4 Scout 宣称 1000 万。到 2026 年,窗口上百万已经是前沿模型的标配。
100 万词元是什么概念,按中文的压缩率折算,大约够装下七部《红楼梦》。整本书直接丢给模型,它不用翻页就能通读。而整个增长曲线最陡的地方,恰好落在你开始用 AI 的这两年。
为什么不能无限大
窗口不是厂商抠门,是账算不过来。
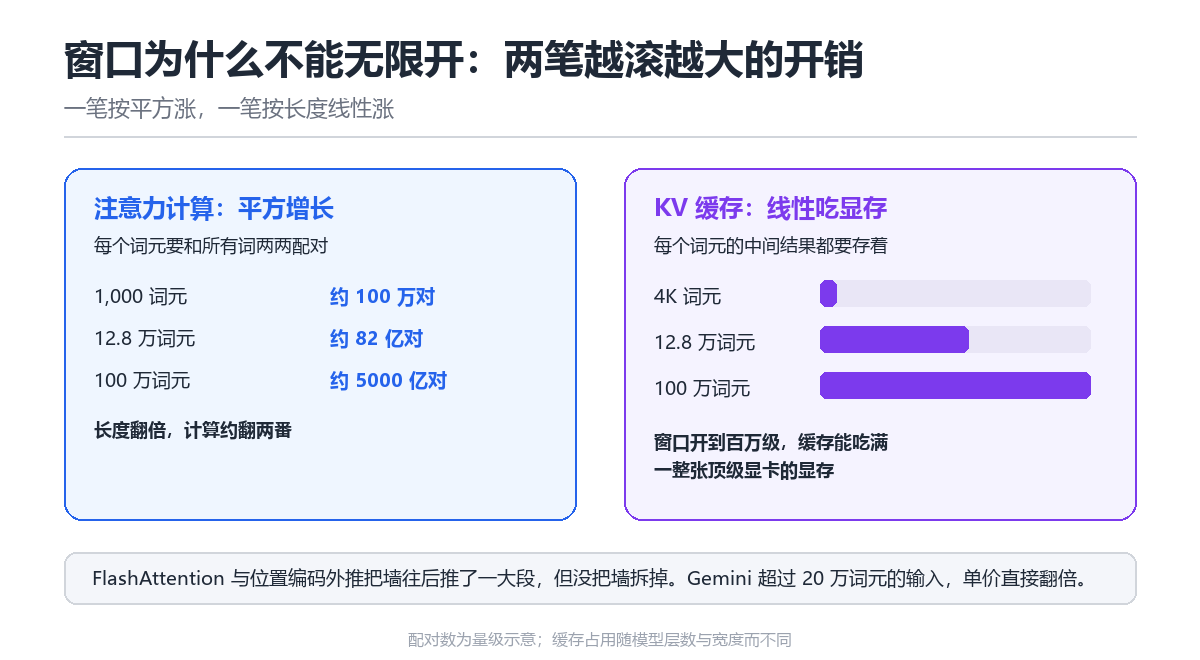
第一个原因在注意力。前面讲 Transformer 时说过,每个词都要和句中所有词两两算相关度。词元数翻一倍,两两组合的数量约翻两番。从 1000 词元扩到 100 万,注意力的计算量按平方膨胀,再强的芯片也扛不住这个涨法。
第二个原因是显存。模型处理长文本时,会把每个词元算出的中间结果存起来避免重复计算,这块缓存随长度线性增长。窗口开到百万级,光缓存就能吃掉一整张顶级显卡的显存。这也是为什么长上下文的 API 要加价:Gemini 超过 20 万词元的输入,单价直接翻倍。
工程界这几年一直在打这两个瓶颈,FlashAttention 把注意力的内存开销从平方压到线性,位置编码外推技术让模型在训练长度之外还能继续扩展。窗口能涨到今天这个数,靠的就是这一串优化接力。但优化只是把墙往后推,没有把墙拆掉。
窗口大,不等于记性好
这里有个容易被宣传数字掩盖的事实:装得下,和用得好,是两回事。
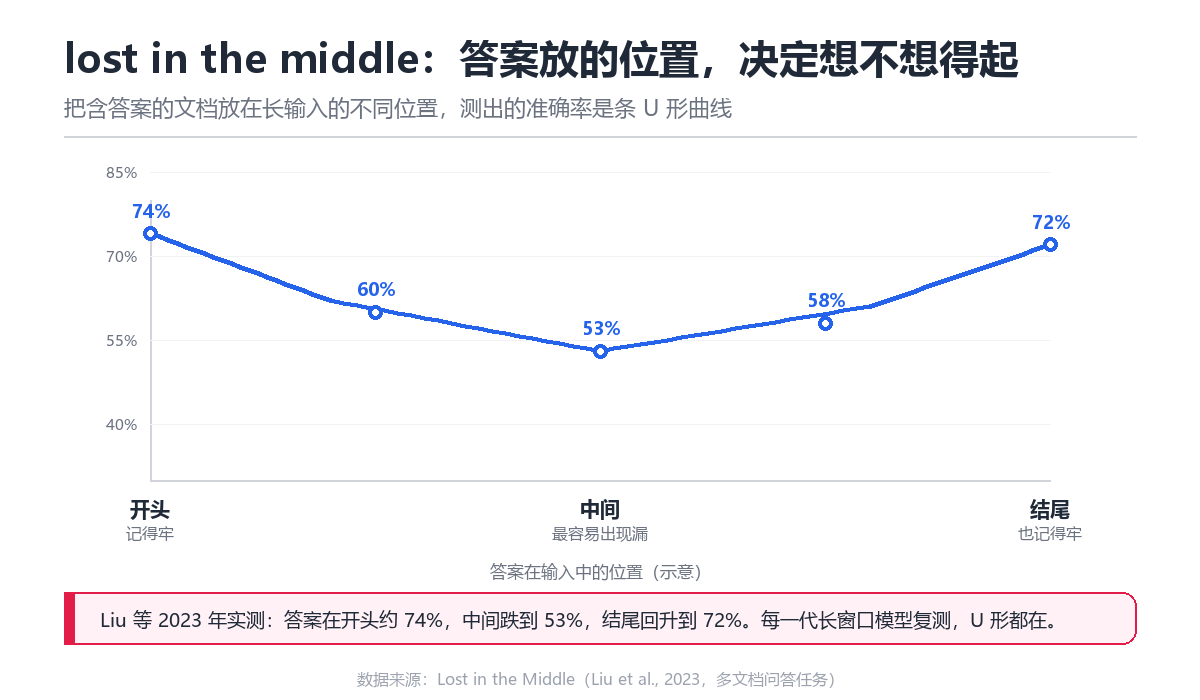
2023 年斯坦福团队做了个实验,把含答案的文档放在不同位置测准确率,结果画出一条 U 形曲线:开头和结尾的信息记得牢,塞在中间的掉了二十个百分点以上。这个现象后来被叫作 lost in the middle,迷失在中间。之后的每一代长窗口模型都被拿去复测,U 形还在,只是中间的坑浅了一些。
2024 年英伟达的 RULER 评测换了个更刁的测法,不只找一句埋进去的话,还要模型做跨段落的追踪和汇总。结论更扎心:宣称支持 32K 以上的 17 个模型,只有约一半在 32K 长度上还保持合格成绩,多数模型的有效上下文只有标称值的五六成。
所以厂商演示里常用的“大海捞针”测试要看清楚:捞一根针是简单的查找,真实任务往往要在几十页里把散落各处的线索连起来,后者难得多。
怎么用好这个窗口
几条能直接照做的建议。
关键信息放开头或结尾,别埋在中间,U 形曲线两头就是它的舒适区。给模型的材料先做提纯,别把没整理的原始资料整坨倒进去,塞满窗口不加分,反而稀释重点,实测显示无关内容越多,回答质量越往下掉。多轮长对话里,十轮之前定下的约定可能已经滑出注意区,重要约束在后面几轮重申一遍。对话实在长了,开个新窗口把要点带过去,常常比硬撑着续聊效果好。
资料远超窗口时的正路是检索:先用工具从海量文档里找出最相关的几段,只把这几段塞进窗口。这就是常被提到的 RAG,检索增强生成。窗口再大的模型,也绕不开它,因为把一整库资料全塞进去,既贵又吵。
窗口和记忆是一回事吗?
不是。窗口只在一次对话里有效,关掉就清空,它是工作记忆。你感觉 AI“记得你”,靠的是厂商把历史聊天存在服务器上,下次再塞回窗口里,那是外挂的记忆系统。两者常被混为一谈,机制完全不同。也正因为如此,换一个模型,它对你的了解就从零开始。
为什么聊久了 AI 会忘事?
窗口有限,聊天记录越滚越长,最早的几轮要么被截断,要么被摘要压缩。你以为它忘了,其实是那段内容已经不在窗口里。另外就算还在,中间位置的信息召回率也低,lost in the middle 说的就是这个。有些产品会在快满时自动把旧对话压成摘要腾地方,代价是细节丢失,被压掉的内容可能恰恰是你后面要用的。
窗口越大收费越贵吗?
通常分档。多数平台给每个模型定一个基础窗口,超出某个长度阈值后单价上浮,也有个别型号对百万级窗口统一不加价。选型时别只看最大窗口,算一笔账:你的任务真的需要每次都塞几十万字进去吗,先用检索把相关的几段找出来,往往比整本塞进去又便宜又准。
写在最后
上下文窗口是大模型的工作记忆容量,词元计价,输入输出共用一张草稿纸。它七八年涨了两万倍,但计算按平方涨、缓存按长度涨,注定不能无限开;装得下也不等于用得好,中间的信息照样会迷失。
对使用者来说,记住三件事:窗口是共享预算,回答也要占地方;关键信息放开头结尾;材料先提纯再喂。下一篇换个视角,同样一个模型,学习时和干活时的算力账完全不同,训练与推理的区别,下篇拆解。
相关文章








