

上一篇讲 Transformer 时留了个钩子:你输入的每个字,是怎么变成模型口粮的。中间经手的那个东西叫词元,英文 Token。它是大模型世界的通用度量衡:上下文窗口按它算,API 账单按它收,模型真正读到的每一个符号也都是它。你写的每一个字都要先过一道切碎工序,才能进模型。这篇把这道工序拆开看清楚。
模型眼里的文字,既不是字也不是词
你看到的是一句话,模型看到的是一串词元。词元是个介于字和词之间的单位,可能是一个完整的常用词,可能是词的一截,也可能只是一个标点。
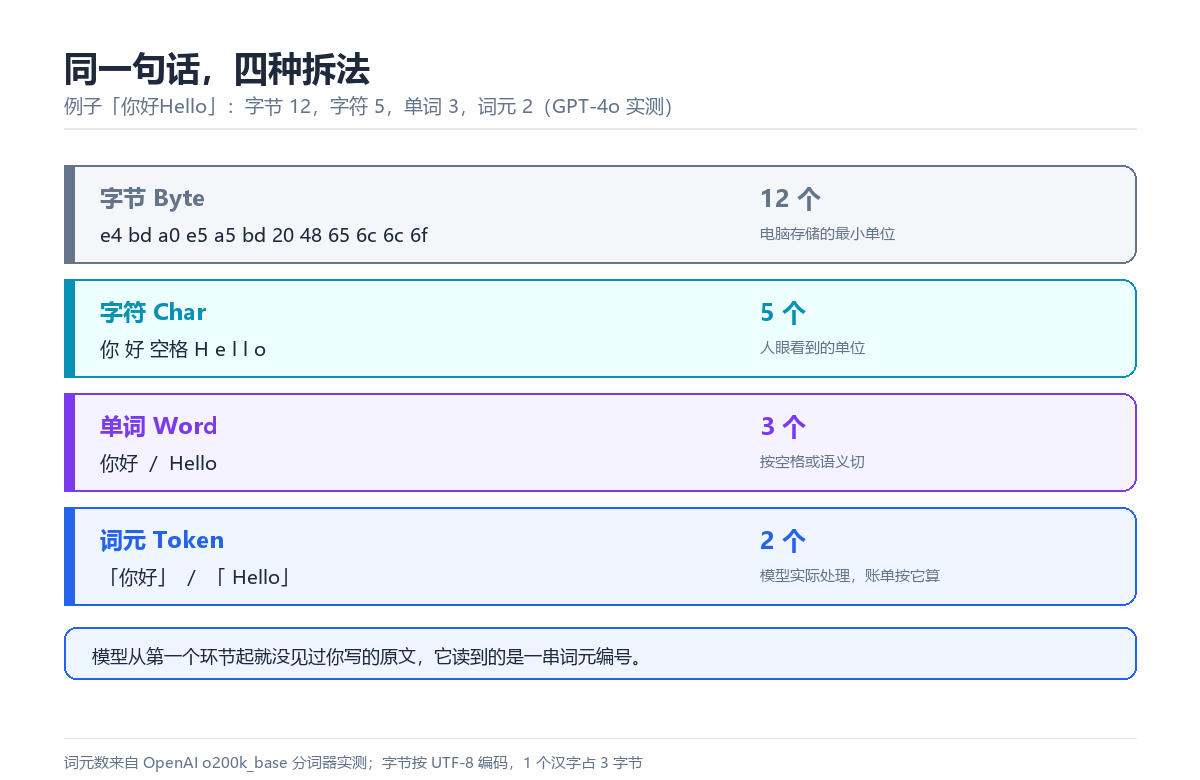
同一段文字其实有四种拆法。以“你好Hello”为例:电脑存起来是 12 个字节;人读起来是 5 个字符;按词切是“你”“好”“Hello”3 个词;而 GPT-4o 实际处理的是 2 个词元,“你好”合并成一个,“ Hello”占一个。字节是存储单位,字符是给人看的单位,词元才是模型工作的单位,模型从第一个环节起就没见过你写的原文。
为什么不直接用字符或单词?两个极端都有硬伤。按字符切,“Hello”变成 5 个单位的序列,一篇千字文的长度翻好几倍,而自注意力的计算量随序列长度平方增长,成本直接失控。按单词切,词表得装下所有语言的所有词,再加上错别字、人名、每月冒出来的新词,清单没有尽头,遇到词表里没有的词就彻底没法处理,模型连读都读不进去。词元在两头之间取了个折中:用几万到二十万块“积木”,拼得出任何文字,高频内容占的序列又短。
词表是这么练出来的
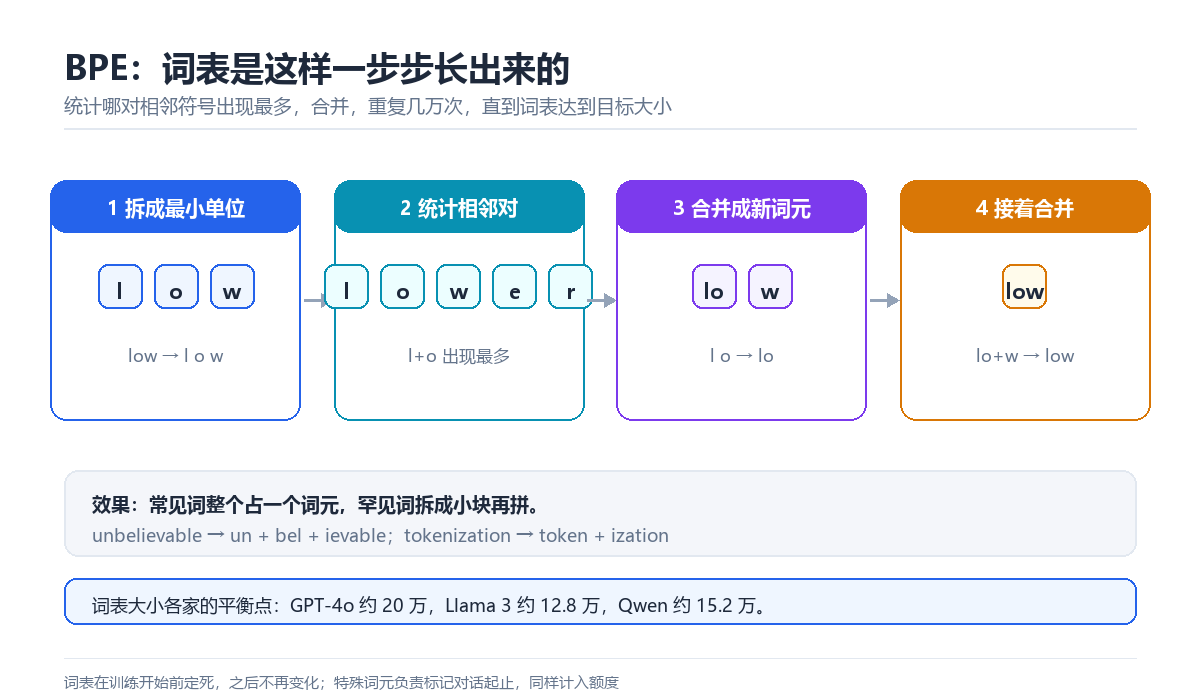
主流模型都用 BPE 算法建词表,全称字节对编码。这套算法 1994 年本来是给数据压缩用的,2016 年被引进自然语言处理。过程朴素得像拼积木:先把语料拆成最小单位,统计哪一对相邻符号出现得最多,把它合并成一个新词元,然后接着统计、接着合并,重复几万次,直到词表达到目标大小。拿经典教材例子演示,语料里 low 和 lower 反复出现,l 和 o 这对邻居出现最多,先合并成 lo;接着 lo 和 w 最常见,再合并成 low。高频组合就这样一步步凝固成词表里的正式成员。
合并出来的效果很直觉。常见词“the”和“你好”整个占一个词元;不常见的“unbelievable”被拆成三截;“tokenization”拆成 token 加 ization,两块积木一拼完事。词表也不是越大越好,词表翻倍,模型里查词用的那张对照表跟着变大,低频词元还学不充分。各家取了不同的平衡点:GPT-4o 约 20 万,Llama 3 约 12.8 万,Qwen 约 15.2 万。词表在训练开始前就定死,模型一辈子只用这一套积木。词表里还藏着一批特殊词元,负责标记一段对话从哪开始、到哪结束,它们也占你的额度。
同一句话,中文为什么更贵
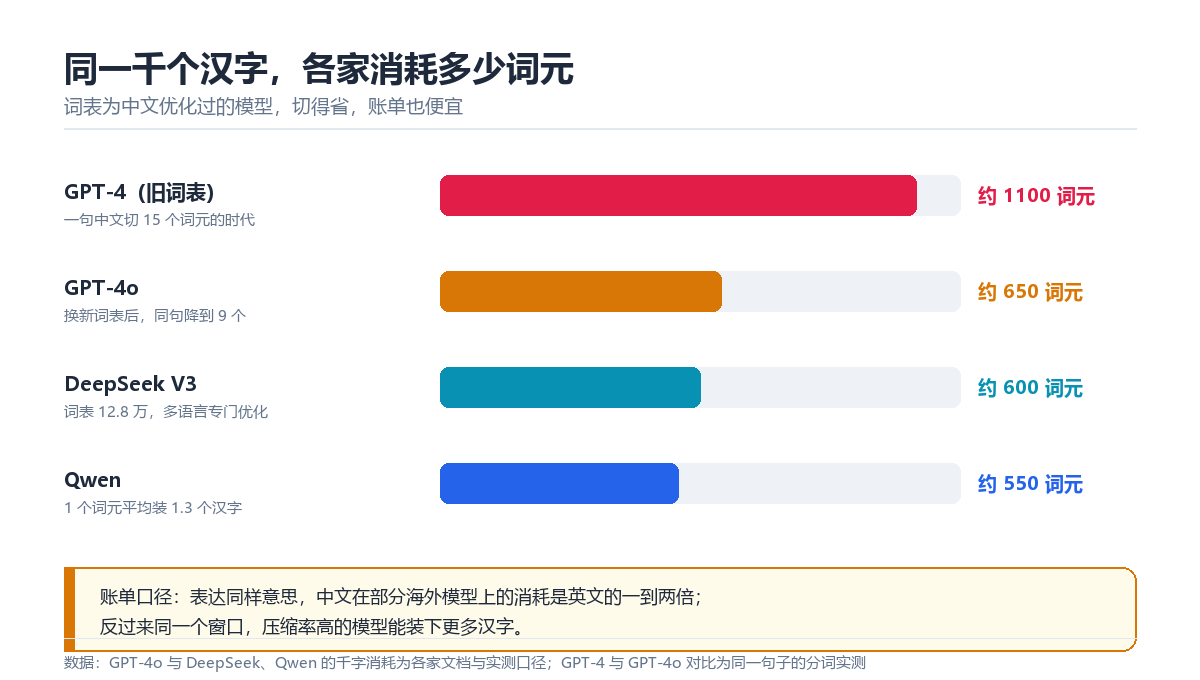
词表主要从哪种语言的语料里练出来,哪种语言就被切得省。老牌模型的词表以英文语料为主,中文吃亏:在 GPT-4 的词表下,一句中文要切出 15 个词元,同样的意思英文只要几个。国产模型专门优化过多语言压缩,浙江大学《大模型基础》的实测数据是,Qwen 平均 1 个词元装 1.3 个汉字,早期的 LLaMA 只装 0.66 个。
差距直接落在账单上。表达同样的意思,中文在部分海外模型上的词元消耗是英文的一到两倍;反过来看同一个上下文窗口,压缩率高的模型能装下更多汉字。换成每千字的直观口径:GPT-4o 处理 1000 个汉字约消耗 650 个词元,DeepSeek V3 约 600,Qwen 约 550 到 670。GPT-4o 换了新词表后,同一句中文从 15 个词元降到 9 个,只换词表就省了四成。选模型先看中文效率,说的就是这件事。
几个著名翻车,根子都在词元
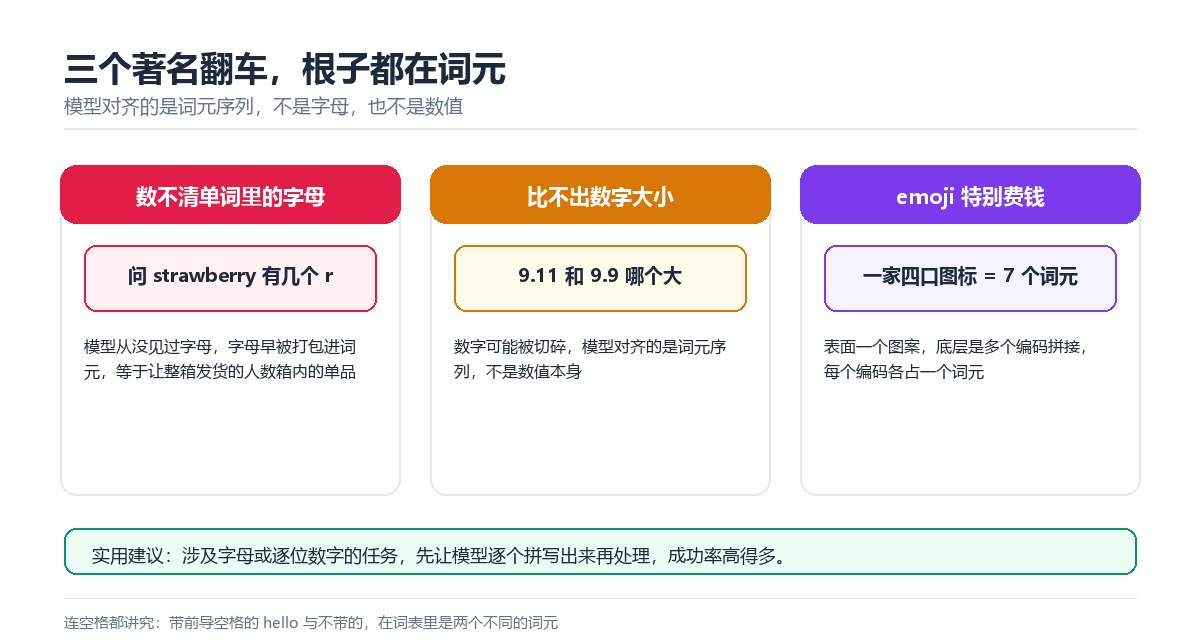
问模型“strawberry 里有几个 r”,它经常数错。不是不识字,是它从没见过字母:词元是它的最小单位,字母早被打了包,让它数字母等于让整箱发货的人数箱里有几件单品。这个词源自 2024 年网上的一轮大规模测试,各家的旗舰模型接连栽在上面,才把“模型看不见字母”这件事顶上了热搜。
“9.11 和 9.9 哪个大”同理。数字在分词时可能被切碎,模型对齐的是词元序列,不是数值本身。emoji 更夸张,那个一家四口的组合图标,表面一个图案,实际吃掉 7 个词元,因为底层是多个编码拼接。连空格都讲究,带前导空格的“ hello”和不带的“hello”,在词表里是两个不同的词元。
这些翻车对使用者有一条实际建议:任务涉及字母拼写、逐位数字时,别默认模型看得见单个字符。让它先一个字母一个字母拼出来再数,或者把数字写成不容易切碎的格式,成功率会明显提高。
账单和窗口,都按它结算
API 计费按词元算,输入和输出分开计价,通常以每百万词元为单位,输出单价普遍是输入的好几倍,因为生成是一个词元一个词元往外蹦,没法并行偷懒。对话里贴一份长文档,每轮都要重新计费,多轮聊下来,历史消息的重复开销比你想的大。上下文窗口的数字,无论 12.8 万还是 20 万,说的都是词元总量,输入加输出一起占额度,超了要么被截断要么直接报错。给输出留多少额度也有讲究,参数设小了,回答写到一半会被硬生生掐断,看起来就像模型摆烂。省钱的路径也在这里:重复使用的系统提示词可以走缓存,部分平台对缓存部分能打到一折以下。
常见问题
词元和字数怎么粗略换算?
英文 1 个词元约合 4 个字符或 0.75 个单词,1000 个词元大约对应 750 个英文单词。中文看模型,新词表大约 1 个词元对应 1 到 1.5 个汉字,反过来 1000 个汉字大概要花 550 到 700 个词元。要精确数字,各家都提供官方分词器工具,粘贴进去就能数,靠经验估算的误差能到两成。
换个模型,同一篇文章的价格为什么不一样?
各家词表不同,切出来的词元数就不同,单价又各定各的,两个变量叠在一起,同一篇文章在不同模型上的花费可能差出一倍。算成本要把压缩效率和单价放在一起看,只盯着单价容易误判。
字节级模型会取代词元吗?
Meta 在 2024 年底提出过直接读字节的架构 BLT,连词表都不需要,任何语言一视同仁,emoji 也不再吃亏。但字节序列比词元长三到四倍,注意力的平方开销跟着翻倍,综合下来未必合算。2026 年的主流商用模型仍然全在词元上,短期内看不到切换。
写在最后
词元是理解大模型的一把钥匙:计费、窗口、翻车、语言差异,全都从“文字被切成什么”这第一个环节长出来。你花出去的每一分钱,都是按这份切法结算的。
下一篇回到模型内部,看预训练和推理这两个阶段到底有什么区别,训练为什么烧卡,回答为什么按秒计。
相关文章








