

在 AI 绘画工具里输入一句话,十几秒后一张图就冒了出来。背后干活的引擎叫扩散模型(Diffusion Model)。它画画的方式听起来不像画画,倒像修照片:从一团雪花噪点里,一遍一遍地往出擦,擦着擦着,一张清晰的图就出现了。
从雪花噪点里擦出一张图
扩散模型的核心动作就两个:先加噪,再去噪。
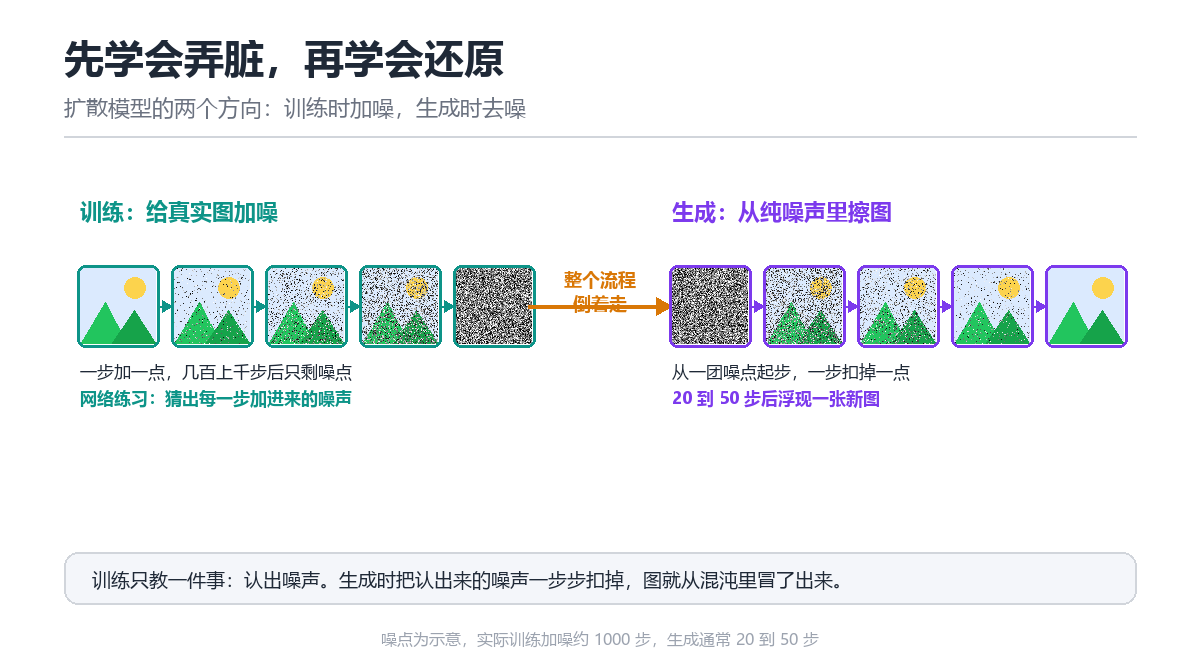
训练的时候,它拿一张真实图片,一点一点往上撒噪声,撒几百上千步,直到图片彻底变成雪花噪点。每撒一步,都让一个神经网络猜:这一步加进来的噪声长什么样?猜完对答案,猜错了就调整。练上亿轮之后,这个网络对噪声越来越熟,给它任何一张带噪点的图,它都能指出哪些像素是杂质。
生成的时候,整个流程倒过来放。先随机造一团纯噪声,然后让练熟的网络一步一点地把噪声扣掉,几十步之后,噪点里浮现出一张从没存在过的新图。
听着玄,道理其实直白:让模型一口气从噪声变成一张完整的画,太难;只把图擦干净一点点,容易。大难题被拆成了几百个小问题,每个小问题都好学。
两次被冷落,一次大爆发
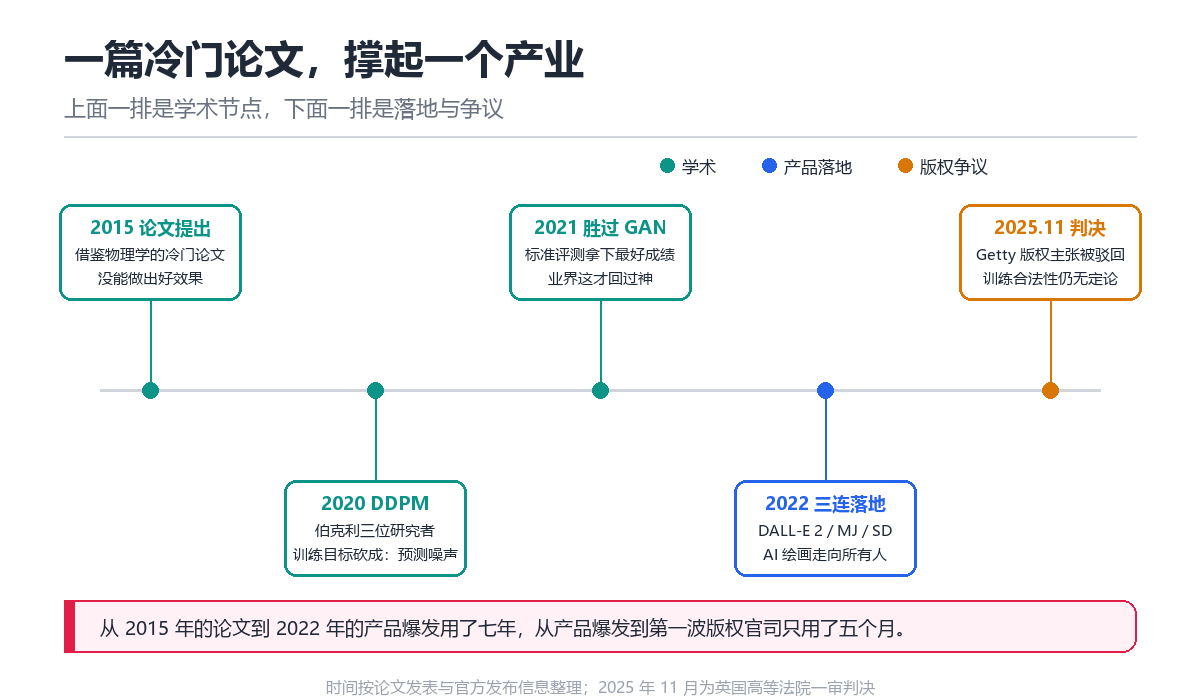
这个思路 2015 年就有人提出来了。一篇借鉴物理学的论文,把墨水在水里散开的过程反过来想:既然墨水能从一坨散成均匀的一片,那反着推不就能从均匀的一片聚回一坨?想法漂亮,但当时没人把图画质量做上去,论文安静地躺了五年。
2020 年,伯克利的三位研究者发出 DDPM 论文,把训练目标砍到只剩一句话:预测噪声。损失函数简单稳定,训练不再折腾。2021 年,后续研究在标准评测上赢过了 GAN,那是当时图像生成领域最好的成绩,业界这才回过神来。
2022 年扎堆落地:4 月 OpenAI 的 DALL-E 2 发布,7 月 Midjourney 公测,8 月 Stable Diffusion 开源。AI 绘画从实验室玩具变成人人可用的工具,前后不到半年。
GAN 为什么让位?它训练时要让两个网络互相博弈,稍不留神就崩;扩散模型只有一个稳定的损失,稳得多,效果还更好。
潜空间:把画布缩小几十倍再动笔
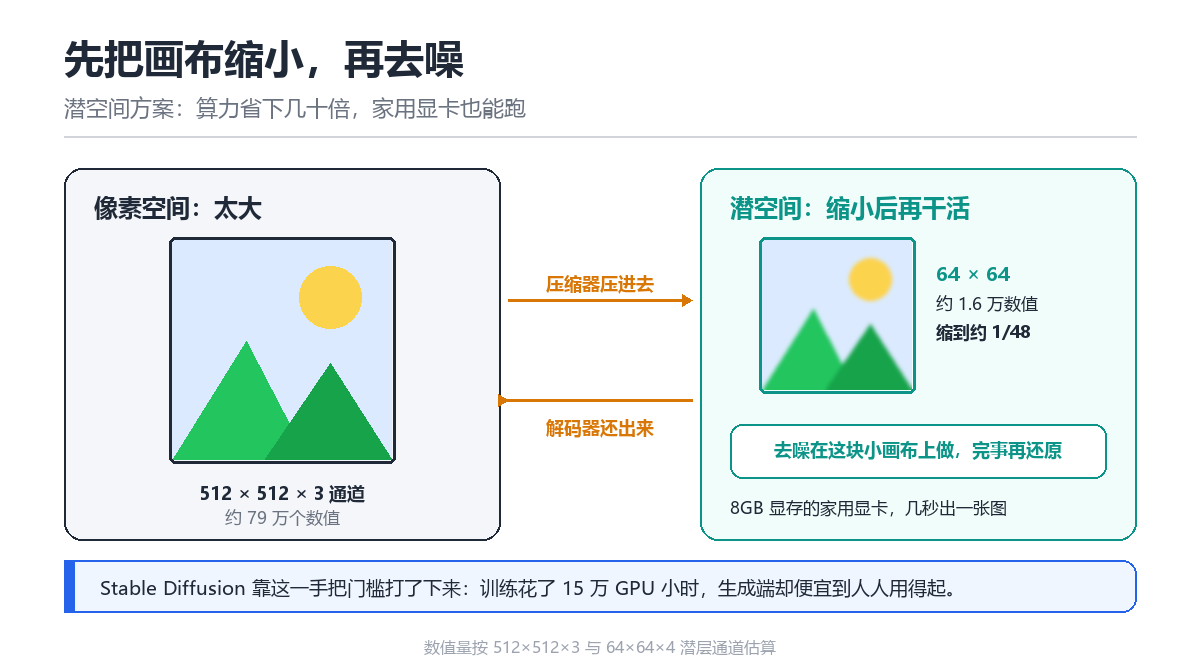
直接在像素上做扩散,太贵。一张 512×512 的彩色图有约 79 万个像素值,每一步去噪都要在这么大的画布上算一遍,几十步下来,普通电脑根本扛不住。
2022 年发布的 Stable Diffusion 用了潜空间方案,学术名叫 Latent Diffusion。思路是先压缩再干活:用一个训练好的压缩器把图按边长缩小 8 倍,数值量降到约 1.6 万,只有原来的四十八分之一。去噪全在这个缩小的空间里做,做完再解压回原图尺寸,画质损失很小,算力省了一大截。
这一省,直接改变了行业格局。Stable Diffusion 的训练用了 256 张 A100 显卡、15 万 GPU 小时(维基百科口径),听着吓人,但生成端只要一块 8GB 显存的家用显卡,几秒钟就能出一张图。模型权重 2022 年 8 月 22 日对外开放,任何人都能下载来改,衍生工具随后大量冒了出来。
一句话是怎么变成一张图的
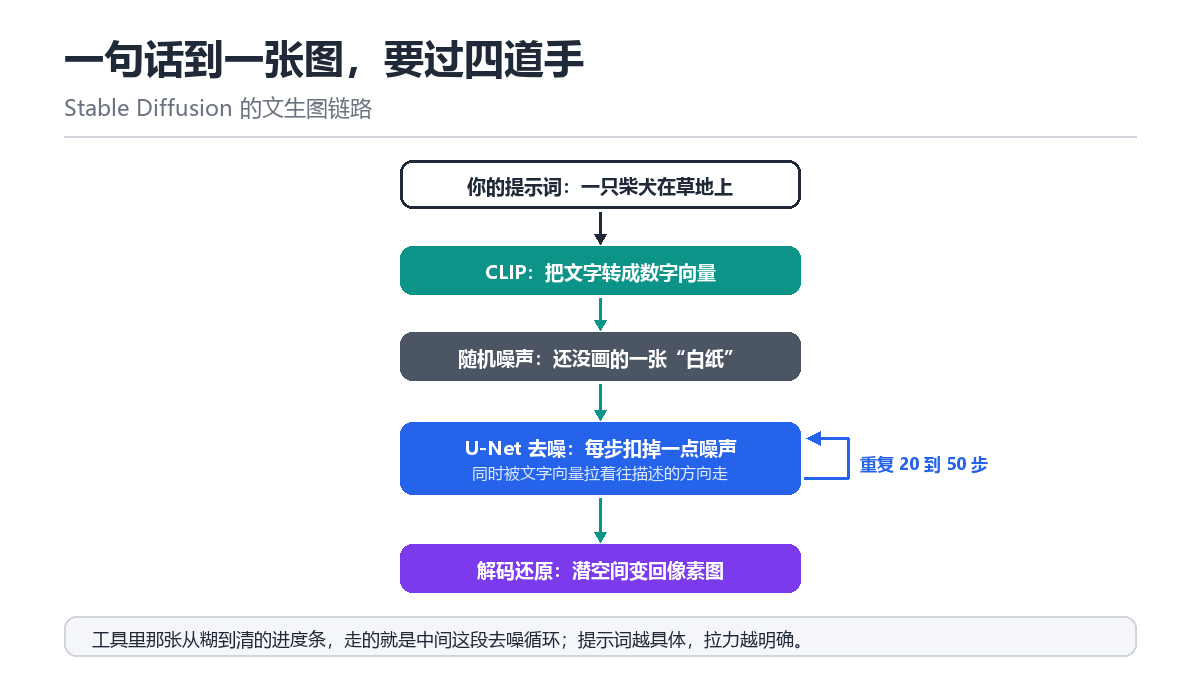
以 Stable Diffusion 为例,从文字到图片要过四道手。
最先出场的是叫 CLIP 的模型,它把你的提示词转成一组数字向量,画面的要求全编码在里面。接着随机生成一团纯噪声,当作用来作画的坯子。然后 U-Net 网络开始干活:每一步预测噪点里的噪声,扣掉一点,同时被文字向量拉着一往符合描述的方向走,反复 20 到 50 步。最后由压缩器把潜空间里的结果还原成真正的像素图。
你会在很多工具里看到进度条从糊到清,那就是去噪在一步一步走。提示词写得越具体,这股拉力越明确,画面就越贴你的想法。
风光背后的官司
Stable Diffusion 的本事来自数据。它的训练数据集叫 LAION-5B,58.5 亿对图文,从公开网页上抓来的。抓的时候基本没打招呼,摄影师和插画师的作品混在其中,谁的图被用了,作者本人并不知情。
2023 年 1 月,图库巨头 Getty Images 在伦敦起诉 Stability AI,说它数百万张版权图片被抓去训练;同月,三位艺术家在美国发起集体诉讼。这场官司打了两年多,2025 年 11 月英国高等法院出了判决:Getty 的核心版权主张被驳回,理由之一是训练没发生在英国;但生成图里出现 Getty 水印的部分,商标侵权成立。
法院也没给这事盖章。法官明确说,一个不存储也不再现版权作品的模型不算侵权复制品,可“用版权作品训练到底合不合法”这个大问题,判决并没有回答。艺术家们的担忧还在:风格被模型学会,反过来跟自己抢饭碗。技术跑在了规则前面,这个缺口至今没补上。
扩散模型和 GAN 有什么区别?
两者都是生成模型,路数完全不同。GAN 让生成器和判别器互相博弈,出图快,但训练不稳,容易崩。扩散模型把生成拆成一步步去噪,训练稳定、画面质量高,代价是生成要跑几十步,速度慢一些。如今主流文生图模型几乎都站在扩散这一边。
为什么 AI 画的手老是出错?
因为扩散模型学到的是画面该长什么样,并不是真正理解手的结构。手部姿态太多,握拳、张开、指点各不相同,训练图里手往往又小又模糊,模型很难凑出五根指头的正确组合,于是经常多一根少一根。新一代模型加大数据、改进结构后已经好不少,但离完全可靠还有距离。
扩散模型只能用来画画吗?
不是。图像修复、超分辨率这些老本行它干得很好,视频生成也走这条路,2024 年问世的 Sora 就是扩散架构。它还能生成音频、设计药物分子。只要是把噪声变成有结构的东西,扩散这套思路都排得上用场。
写在最后
扩散模型的故事有个少见的剧本:一篇 2015 年没引起多少动静的论文,五年后被人捡起来擦亮,再过五年,它撑起了整个 AI 绘画产业。它教会模型的是一件朴素的事:弄脏一条路很容易,学会倒着走回去,就能从混沌里造出东西来。
开源的 Stable Diffusion 和闭源的 DALL-E、Midjourney,两条路线的争论从这个产业诞生起就没停过。下一篇我们聊开源模型和闭源模型到底差在哪,普通用户该怎么选。
相关文章








