

你打开一个 AI 对话框,几秒钟它就吐出一段通顺的回答。这背后除了模型和数据,还压着一个常被忽略的东西:算力。它看不见也摸不着,却决定了模型能长多大、能有多聪明、能同时服务多少人。
这篇文章把算力这个词拆开讲清楚,也回答另一个更实际的问题:为什么 AI 的每一次进步,都要先问一句算力够不够。
算力是什么:每秒能算多少次
算力最严谨的定义,是计算机系统在单位时间内能完成的浮点运算次数。浮点数就是带小数点的数,AI 里大量的矩阵乘加运算都是浮点运算,所以衡量算力的单位是 FLOPS,也就是每秒浮点运算次数。
这个单位有一串量级:TFLOPS 是每秒万亿次,PFLOPS 是每秒千万亿次,EFLOPS 是每秒百亿亿次。一部手机大致在几到几十 TFLOPS,一台超级计算机能到 EFLOPS 这个级别。国内统计算力时统一采用单精度浮点(FP32)的理论峰值做基准,免得各家精度口径不同,数字对不上。
EFLOPS 到底有多快?美国超算“前沿”的峰值已经突破 1 EFLOPS。换个说法,一个人按计算器一秒按一次,它一秒算完的东西,80 亿人一起按,要按将近 40 年。
通用、智能、超算:三种算力干三种活
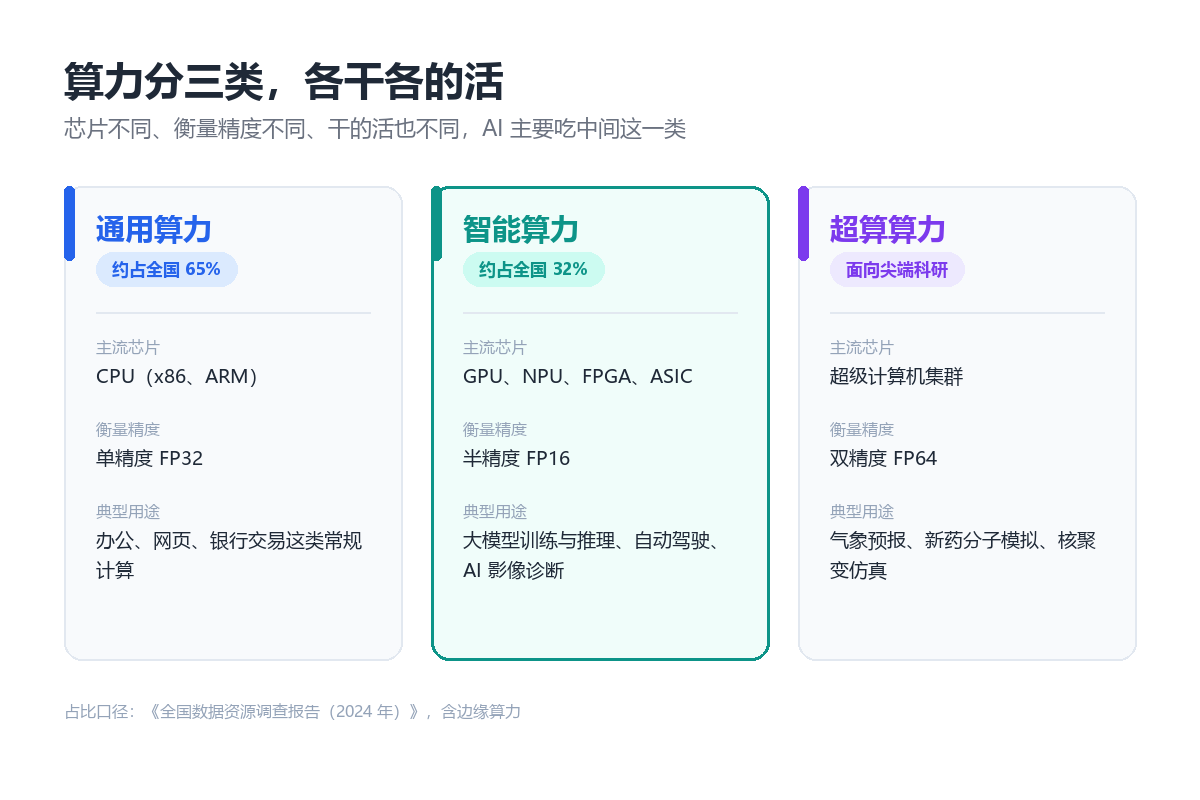
日常说的算力其实是三类,按芯片和用途分。通用算力主要靠 CPU,用单精度浮点衡量,管的是办公、网页、银行交易这类常规计算,在我国算力总规模里占大头,大约六成五。超算算力靠超级计算机集群,用双精度浮点(FP64)衡量,跑的是气象预报、新药分子模拟、核聚变仿真这类尖端科研。
真正跟 AI 绑在一起的是智能算力,主力是 GPU,还有 NPU、FPGA、ASIC 这类加速芯片,用半精度浮点(FP16)衡量,按 2024 年的统计口径约占全国算力总规模的三成二。
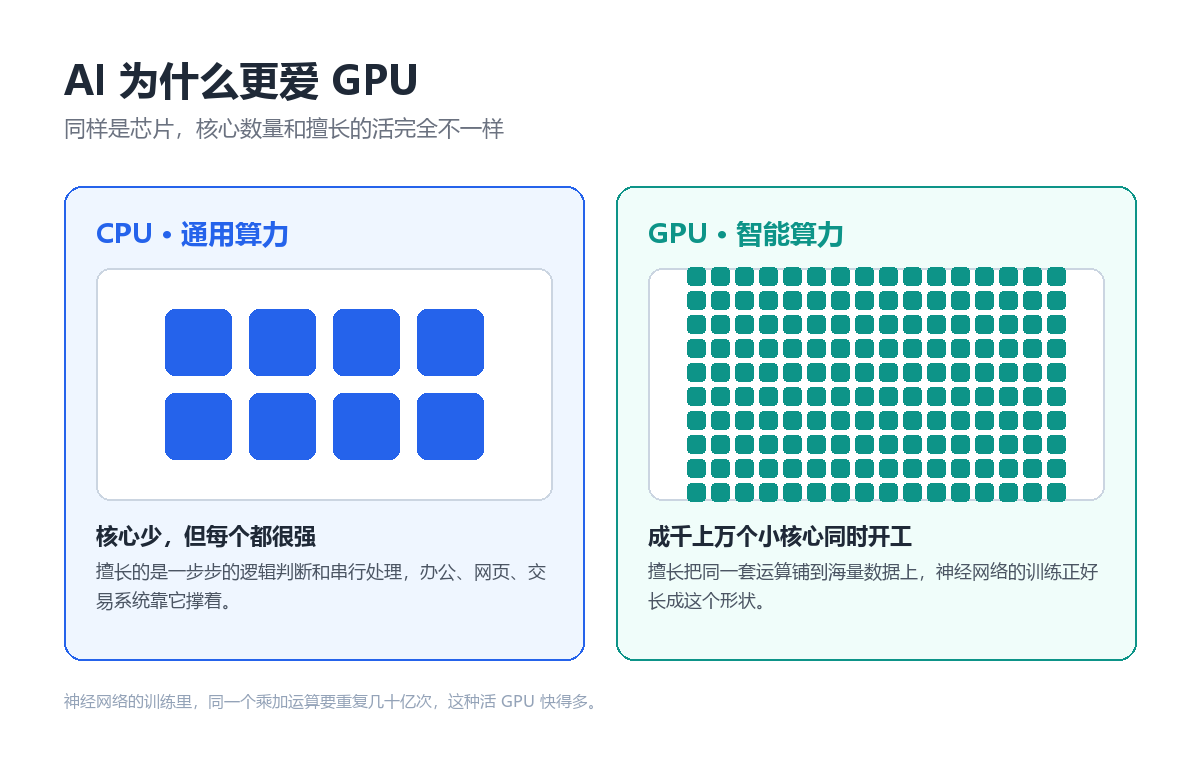
为什么 AI 更偏爱 GPU?CPU 的核心数量少,强在复杂的逻辑判断和串行处理;GPU 身上挂着成千上万个小核心,擅长把同一套运算同时铺到海量数据上。神经网络的训练正好是这个形状,同一个乘加要重复几十亿次。这种需求上的错配,直接把 GPU 变成了这个时代最紧俏的硬件。
为什么 AI 发展离不开算力
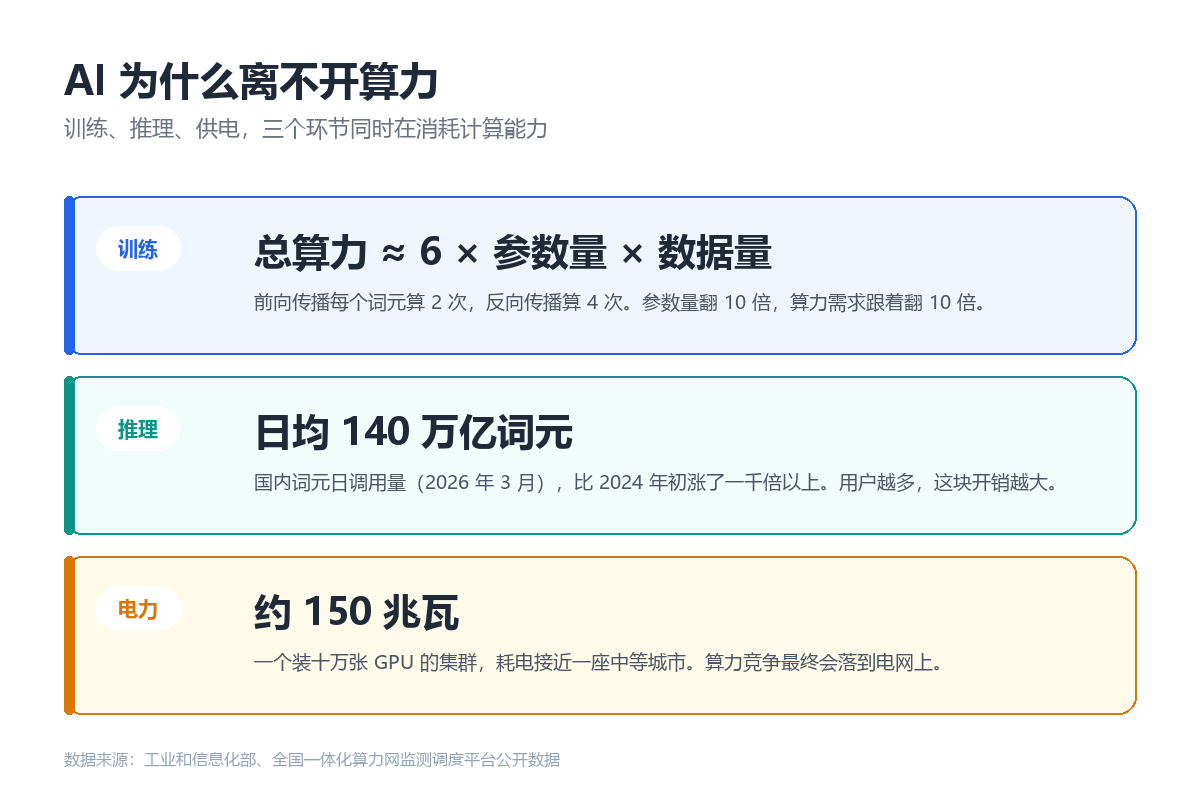
第一层原因在训练。大模型训练的本质,是把海量文本反复做矩阵运算,把几千亿个参数一点点调到位。业内有个估算公式,训练总计算量大致等于参数量乘数据量再乘 6,前向传播每处理一个词元要 2 次运算,反向传播要 4 次。参数量翻十倍,算力需求也跟着翻十倍。想不想把模型做大,说到底是有没有那么多算力的问题。
更要紧的是,投入和产出之间有一条可以预测的曲线。2020 年 OpenAI 发现,模型的损失随着参数量、数据量和算力的增加呈幂律下降。这条规律后来被反复修正,2022 年 DeepMind 补上一个重要条件:算力固定时,模型大小和训练数据量应该同步增长,最优比例约每个参数配 20 个词元。他们的实验很能说明问题,同样算力下,700 亿参数配 1.4 万亿词元的模型,在几乎所有测试里打赢了 2800 亿参数只配 3000 亿词元的对手。
于是整个行业开始追着算力跑。用于顶级模型训练的算力,2010 年以来每年增长大约 4 到 5 倍,摩尔定律每年一倍多的增速早就跟不上。到 2025 年,一次前沿训练的规模已到 10 的 26 次方次浮点运算这个量级,花费以亿美元计。
第二层原因在推理。模型训练完并不等于终点,用户每问一句、系统每生成一段,都要实打实跑一遍计算。国内的词元日调用量在 2026 年 3 月已经突破 140 万亿,比 2024 年初涨了一千倍以上。用户越多,这块开销越大。近两年还多了个变化,让模型回答难题时多想一会儿,用更多计算换准确率,成本能差出几个数量级。
第三层原因是电。算力不会自己长出来,它要用电换。一个装了十万张 GPU 的集群,耗电大约 150 兆瓦,规模接近一座中等城市的用电量。有测算认为,如果按现在的路线继续堆下去,到 2030 年前后卡住训练规模的会是电力和芯片产能,而不是数据或算法。
算力够大,模型就一定聪明吗
不一定。算力、数据、算法是三个得凑齐的条件。数据是原料,算法是方法,算力是动力。算力不够,再好的设计也训不起来;数据不够,算力就在空转。高质量公开文本预计在 2026 到 2032 年之间被用得差不多,这个瓶颈已经摆在眼前。
而且算力堆到一定规模,边际收益会递减。同样的算力预算,架构怎么选、数据怎么配、训练多久,结果能差出不少。算力更像是入场券,拿到它才有资格上桌,但它本身不保证赢。
中国的算力现在到了什么水平
工业和信息化部 2026 年 1 月在国新办发布会上介绍,我国已建成万卡智算集群 42 个,智能算力规模超过 1590 EFLOPS,位居全球前列。作为对比,IDC 与浪潮信息联合发布的评估报告显示,2024 年中国智能算力规模是 725.3 EFLOPS,2023 年是 416.7 EFLOPS,两年翻了一倍多。
到 2026 年 3 月,这个数字进一步涨到 1882 EFLOPS,在用算力中心标准机架达到 1445 万架,建成的算力大通道超过 70 条。这里要留意,上面两个数字统计的都是智能算力。如果连通用算力和超算算力一起算进来,截至 2024 年底,全国算力总规模是 280 EFLOPS,年增速保持在 30% 左右,总规模位居全球第二。
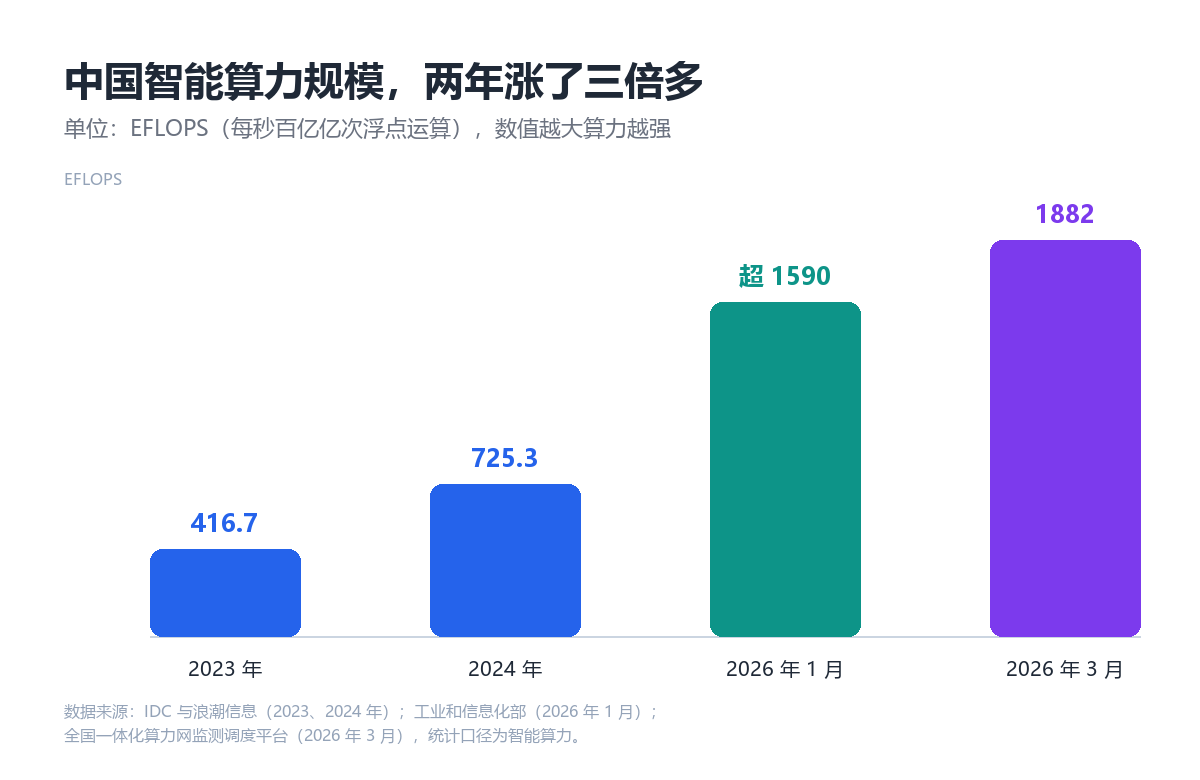
现在正在推的一件事,是把分散的算力连成一张网。全国一体化算力网的目标是让各地智算中心像电网一样统一调配、按需取用,目前监测调度平台已经接入全国约七成的智能计算资源。
关于算力的几个常见问题
算力和芯片是一回事吗?
不是。芯片是提供算力的硬件,算力是它跑出来的能力。同一块芯片跑不同的任务、用不同的精度,发挥出来的算力差别很大。看到“某芯片算力多少 TFLOPS”这类说法,得留意它标注的是什么精度。
算力越大,模型就越聪明吗?
在大规模训练的早期阶段,这个关系相当可靠,投入越多效果越好,还能提前预测。但这条路正在变窄,数据不够用、收益递减、用电受限都是现实约束。业内现在的重点,已经从单纯堆规模转向怎么把每一份算力用得更值。
普通人需要关心算力吗?
需要一点。它决定了你用的 AI 服务有多快、多贵、能不能长期免费。明白算力紧张这件事,就能理解为什么有些能力强的大模型要单独收费,为什么高峰期会排队。
写在最后
算力说到底是一种用电换来的生产能力。它不说话,却规定了这一轮 AI 能走多远:模型规模的上限由它决定,服务成本的高低由它决定,连能源和芯片的产业格局也被它牵着走。下次看到新模型发布,不妨顺手看一眼它训练花了多少算力,那个数字往往比参数更能说明问题。
相关文章








