

什么是大语言模型(LLM)?通俗讲解
你和 ChatGPT、豆包、DeepSeek 对话时,对面那个能读会写、聊什么都接得住的程序,就是大语言模型,英文缩写 LLM。讲它的文章多半停在“它能干什么”,这篇往下一层,说清它是什么、凭什么能行、又为什么会出错。
大语言模型到底是什么
拆开这三个词,概念基本就清楚了。
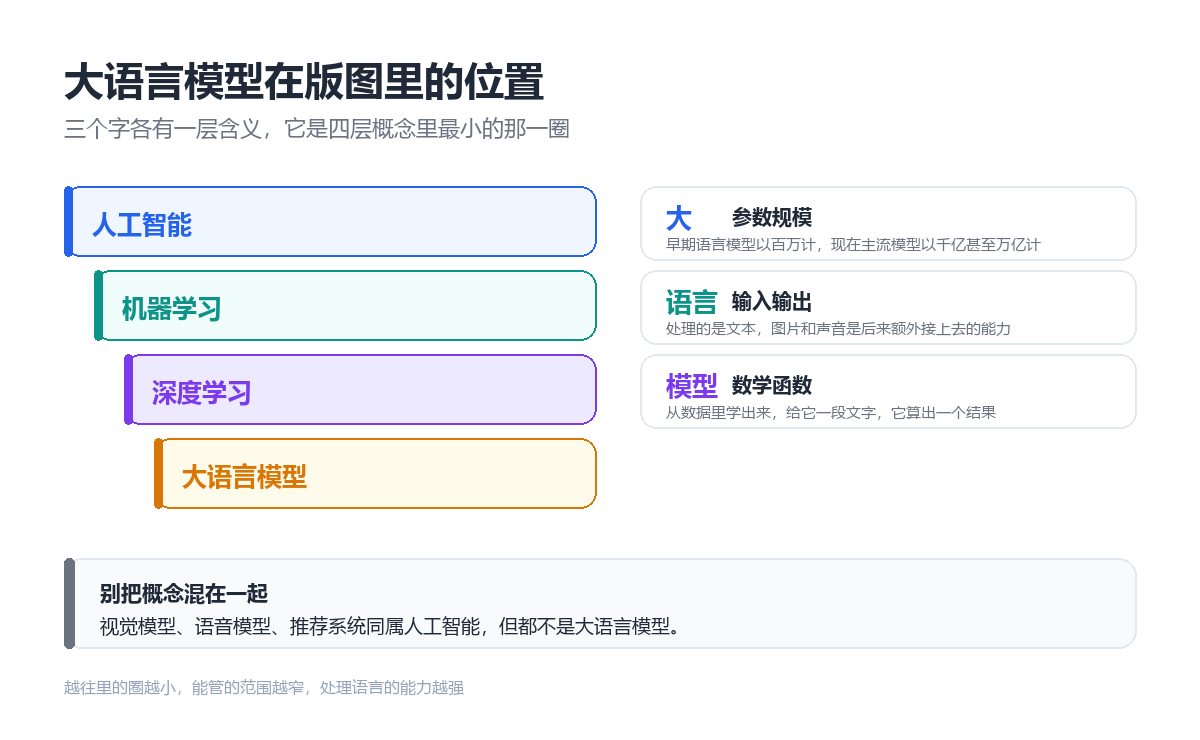
“大”说的是参数规模。参数是模型内部可调整的数值,训练过程就是在调它们。早期语言模型的参数以百万计,现在的主流模型以千亿甚至万亿计。
“语言”说的是它的输入和输出都是文本。它本身不直接处理图片和声音,多模态能力是后来额外接上去的。
“模型”说的是它的本质,一个从数据里学出来的数学函数。给它一段文字,它算出一个结果。
放在版图里看,它的位置很清楚。人工智能是最大的那个圈,机器学习是其中一派,深度学习又是机器学习的一支,语言模型属于深度学习,大语言模型则是语言模型里规模跨过某个量级的那一批。
它其实是一台下一个词预测机
大语言模型做的事情只有一件:给定前面的文字,算出下一个词最可能是什么。
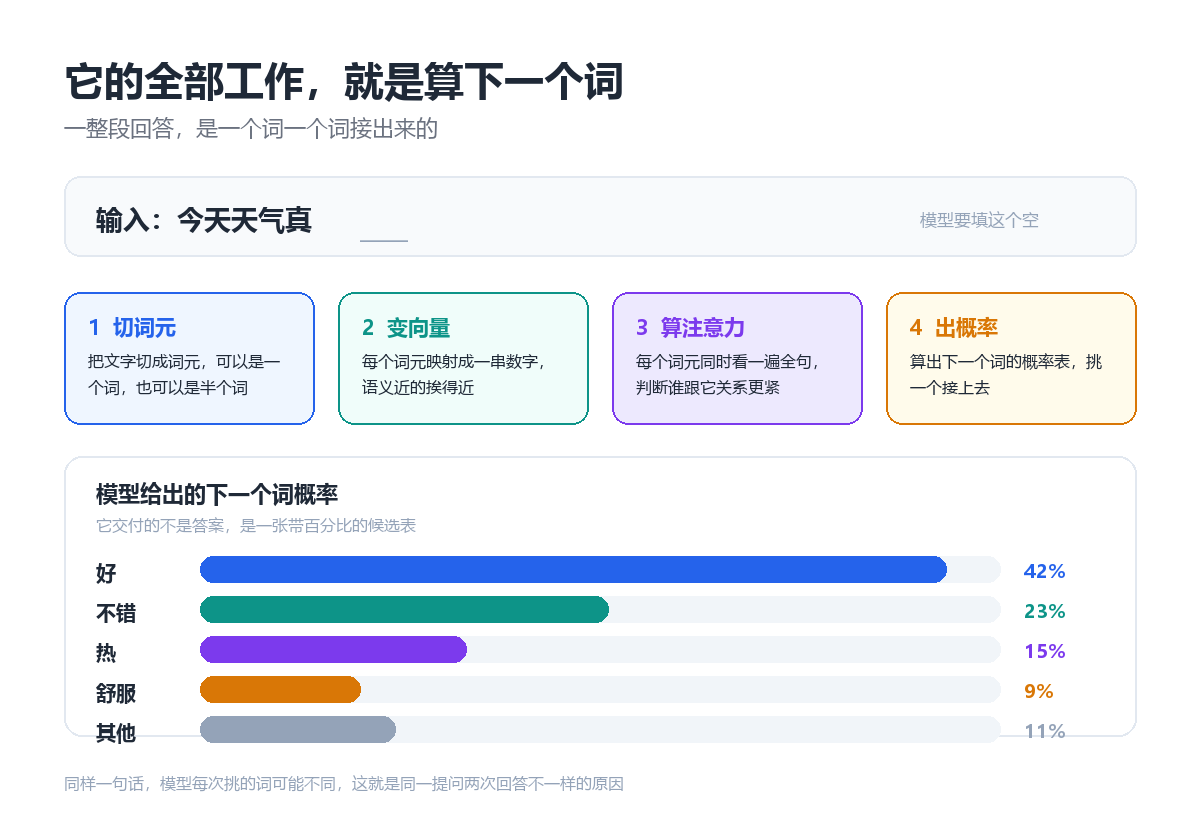
以“今天天气真”为例,模型会输出一张概率表,好、不错、热各自带着百分比,它按概率挑一个接上去,再拿新句子去算下一个词。一整段回答,就是一个词一个词接出来的。
背后是四步。文本先被切成词元,可以是一个词,也可以只是半个词。词元再被映射成一串数字,语义相近的表示在数字空间里挨得很近。接着经过注意力机制,每个词元同时看一遍句子里其他所有词元,判断哪些跟它关系更紧。最后层层计算,输出下一个词的概率分布。
这个机制解释了一件常被误解的事。模型不是在数据库里检索答案,它是在算概率。这是它既流畅又容易出错的同一个根源。
“大”到底大在哪里
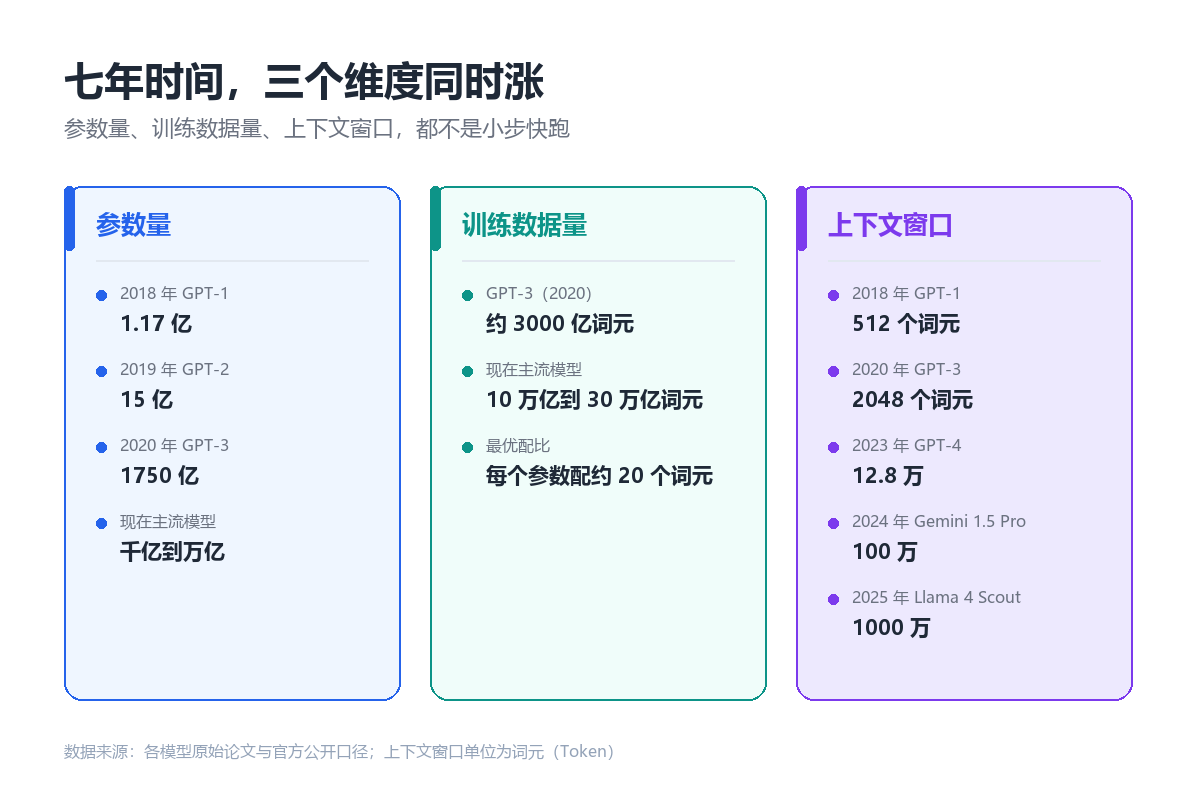
规模有三个维度同时在涨。
参数量方面,2018 年的 GPT-1 是 1.17 亿参数,2019 年的 GPT-2 涨到 15 亿,2020 年的 GPT-3 到了 1750 亿。如今主流开源模型的旗舰版本,普遍在千亿到万亿之间。
训练数据方面,GPT-3 当年用了约 3000 亿词元,现在主流模型的训练量普遍在 10 万亿到 30 万亿词元。2022 年 DeepMind 的研究还补上了一个条件,算力固定时,参数量和数据量应该同步增长,最优比例大约是每个参数配 20 个词元。
上下文窗口,也就是模型一次能看进去多少内容。GPT-1 只有 512 个词元,大约一页纸;GPT-3 是 2048;GPT-4 到了 12.8 万;2024 年 Gemini 1.5 Pro 突破 100 万;2025 年 Meta 的 Llama 4 Scout 对外宣称 1000 万。
规模换来的能力,和一场没吵完的争议
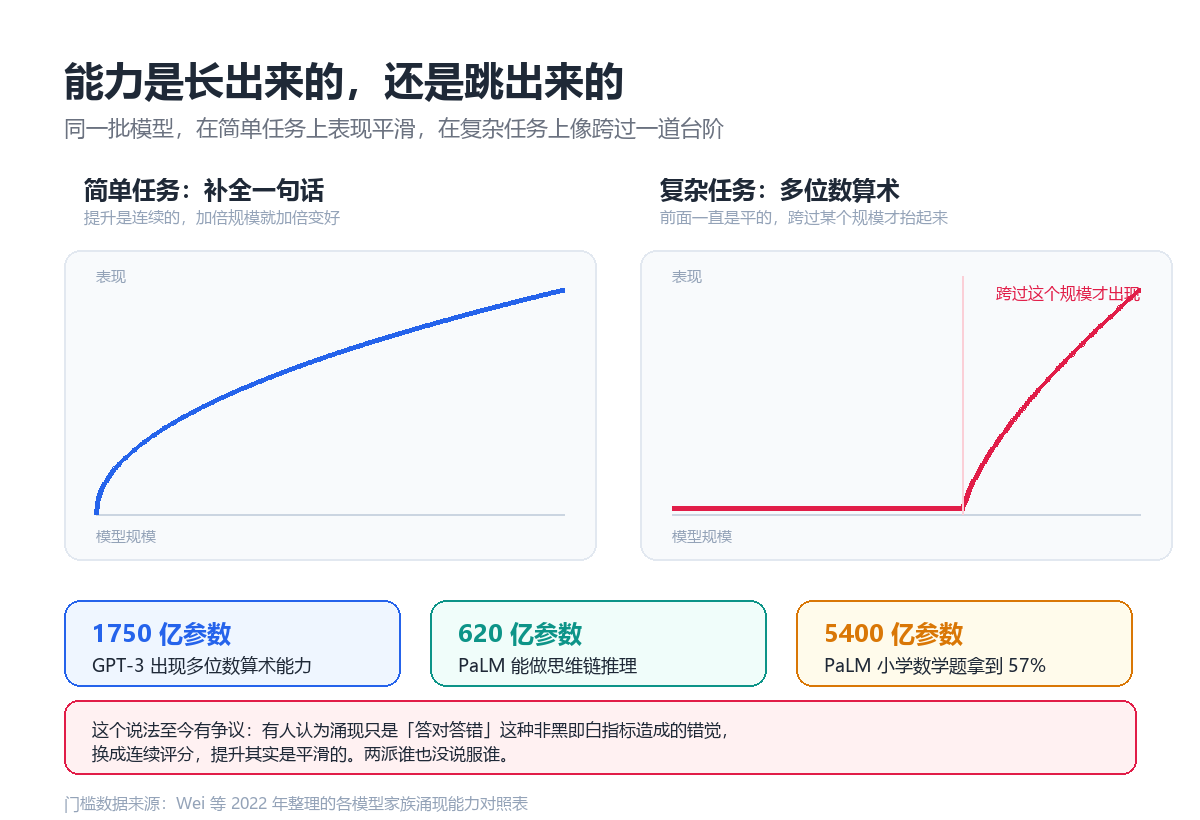
参数涨上去,能力不是等比例变好的。
2020 年 OpenAI 发现,模型的预测误差随着参数量、数据量和算力的增加,在对数坐标上呈一条向下的直线。这条规律叫缩放定律,它让实验室可以事先算出投入多少算力能换来多少提升。
更值得琢磨的是另一件事。有些能力不是慢慢长出来的,而是跨过某个规模之后突然出现。按 Wei 等人 2022 年整理的数据,1750 亿参数的 GPT-3 才做得出来多位数算术,620 亿参数的 PaLM 能做思维链推理,5400 亿参数的 PaLM 在小学数学题上拿到 57% 的分数。研究者把这种现象叫作涌现能力。
这个说法至今有争议。2023 年有研究者提出,涌现可能只是评测方式造成的错觉,用答对答错这种非黑即白的指标去量,曲线看起来是跳的,换成连续评分,提升其实是平滑的。两派到现在都没把对方说服。
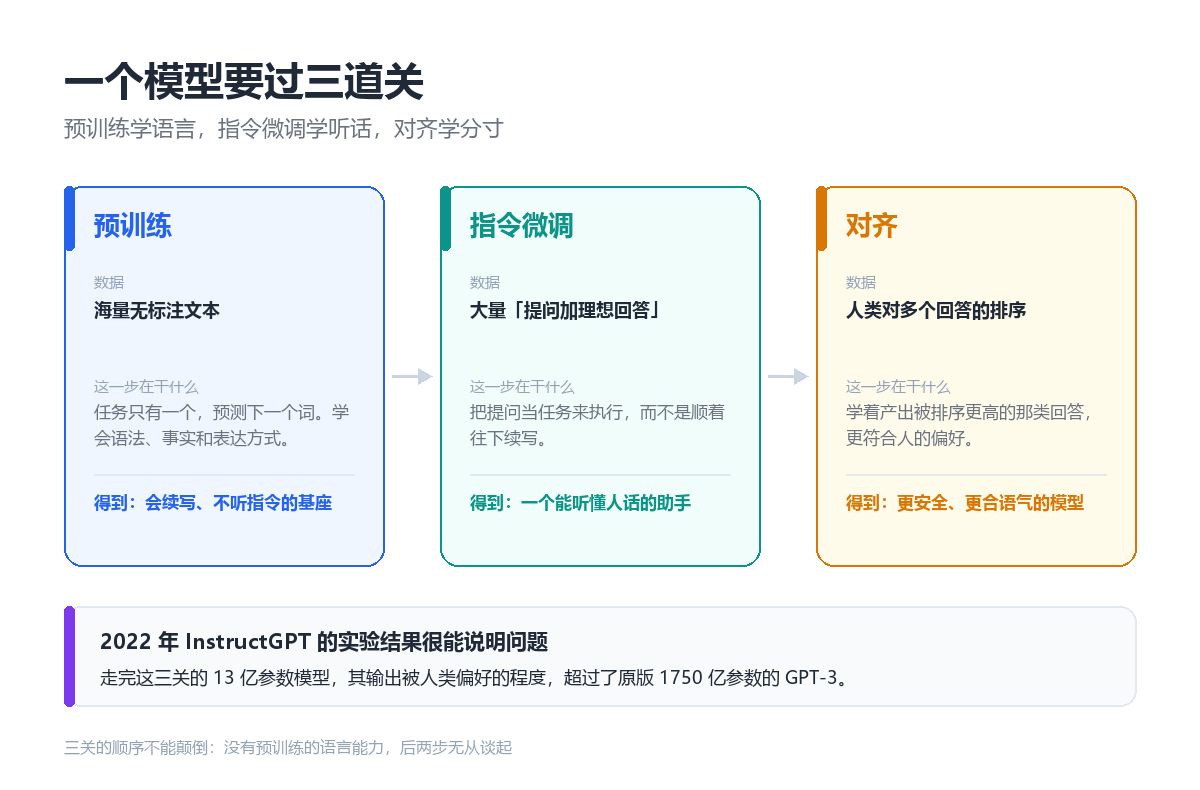
从预训练到对齐,一个模型要过三道关
预训练是花钱最多的一步。模型读进海量无标注文本,任务只有一个,预测下一个词。它在这个过程中学会语法、事实和表达方式。
预训练完的模型还不会好好说话。你问它一个问题,它可能接着把类似的问题一条条列下去,因为它的行为模式是续写。指令微调这一步,用大量“提问加理想回答”的样本,把它从续写机器改造成助手。
最后是对齐。人给模型的多个回答排序,模型学着去产出排序更高那一类回答。2022 年 InstructGPT 的实验很能说明问题,走完这套流程的 13 亿参数模型,其输出被人类偏好的程度超过了原版 1750 亿参数的 GPT-3。
它为什么会一本正经地胡说
因为它的目标是让文字像真的,不是让文字是真的。
生成过程中没有任何环节去核对事实。模型只是每一步挑概率最高的词,而这些概率来自训练数据里的共现规律。当某种说法在语料里反复以相似方式出现,模型就会照着这个形状编下去,编得越顺,越容易被当真。
长上下文又带来一个新麻烦。窗口开得越来越大,不代表模型能均匀地用上里面的信息。研究发现,关键信息埋在长文档中间时,模型反而容易漏掉,这个现象被称为“lost in the middle”。
所以比较稳妥的用法,是把它当成一位知识面很广、但从不核实、也不主动承认不确定的同事。
今天它被用在哪些地方
按 CNNIC 第 57 次报告,截至 2025 年 12 月,我国生成式人工智能用户规模达 6.02 亿,普及率 42.8%。这些用户里,76% 主要用于问答,47.8% 用来生成或处理图像视频,10.8% 用于代码生成。
在应用端,截至 2025 年底,已有 748 款生成式人工智能服务在国家网信办完成备案。这个数字说明它已经走出实验室,进入需要持证上岗的商用阶段。
对个人来说,它最先改变的是写东西、查资料、处理表格这三类活。
常见问题
大语言模型和人工智能是一回事吗?
不是。人工智能是最大的范畴,机器学习、深度学习都在它下面,大语言模型是深度学习里专门处理语言的一支。视觉模型、语音模型、推荐系统同属人工智能,但都不是大语言模型。
参数越多,模型就越聪明吗?
不一定。参数量只是三个变量里的一个,数据量和算力同样关键。2022 年 DeepMind 的研究发现,70 亿参数配足量数据的模型,在一系列测试里能打赢参数量四倍于它、但数据不足的对手。数据质量、训练方法、后训练流程同样决定最终表现。
它真的“理解”自己说的话吗?
这个问题学术界没有共识。从机制上看,它做的是概率预测,没有一步在核对真实世界;可反过来看,一套系统能在各种新任务上稳定给出合理反应,说它完全没有理解也很难自圆其说。更实用的态度是,先看它在你要用的场景里表现如何,再决定给它多大的信任。
写在最后
大语言模型的全部秘密可以压成一句话:用极大的规模,把“预测下一个词”这件事做到足够好,好到从里面长出了翻译、推理和写代码。
理解它,有三个抓手最实用。它算的是概率,不是事实;它的能力来自规模,但规模不等于一切;它一次能看进去多少字,和它能不能用上这些字,是两回事。
下次它答得很顺的时候,不妨多问一句,这个说法它核实过吗。
相关文章








